Itsharkz

Ile kosztuje wdrożenie agenta AI? Modele cenowe, ukryte koszty i jak nie przepłacić

Odpowiedź w skrócie: Wdrożenie agenta AI w Polsce kosztuje w 2026 roku od około 20 000 PLN (prosty agent FAQ) do ponad 400 000 PLN (agent enterprise), plus 2 000–25 000+ PLN miesięcznie za utrzymanie. O cenie decydują typ agenta, integracje, jakość danych, compliance i autonomia. Widełki poniżej opracowaliśmy w ITSharkz na podstawie danych rynkowych i własnych wdrożeń.

Jeśli zapytasz dostawcę agenta AI o cenę wdrożenia, prawdopodobnie usłyszysz: „To zależy.” A potem dostaniesz zapytanie ofertowe.

Ten artykuł rozkłada temat na czynniki pierwsze: trzy modele cenowe dostępne na polskim rynku, koszty, które regularnie znikają z ofert, i framework do porównywania TCO na 24 miesiące. Z konkretnymi widełkami z polskiego rynku 2026.

Dlaczego „zapytaj o wycenę” to zła odpowiedź na pytanie o koszt AI

Nie dlatego, że dostawcy chcą ukryć cenę. Dlatego, że koszt agenta AI zależy od zbyt wielu zmiennych, żeby podać jedną liczbę, która byłaby uczciwa.

Pięć zmiennych, które decydują o cenie bardziej niż cokolwiek innego:

1. Typ agenta i zakres odpowiedzialności. Agent informacyjny (FAQ, knowledge base) kosztuje inaczej niż agent wykonujący operacje w systemach transakcyjnych (aktualizuje ERP, generuje faktury, inicjuje zwroty). Różnica w złożoności: wielokrotna.

2. Liczba i charakter integracji. Każda integracja z zewnętrznym systemem (ERP, CRM, WMS, API przewoźnika) to osobny koszt analizy, mapowania, implementacji i testów.

3. Jakość i dostępność danych. Jeśli dane historyczne są nieustrukturyzowane lub wymagają czyszczenia przed indeksowaniem – to jest koszt, który często nie pojawia się w pierwszej ofercie.

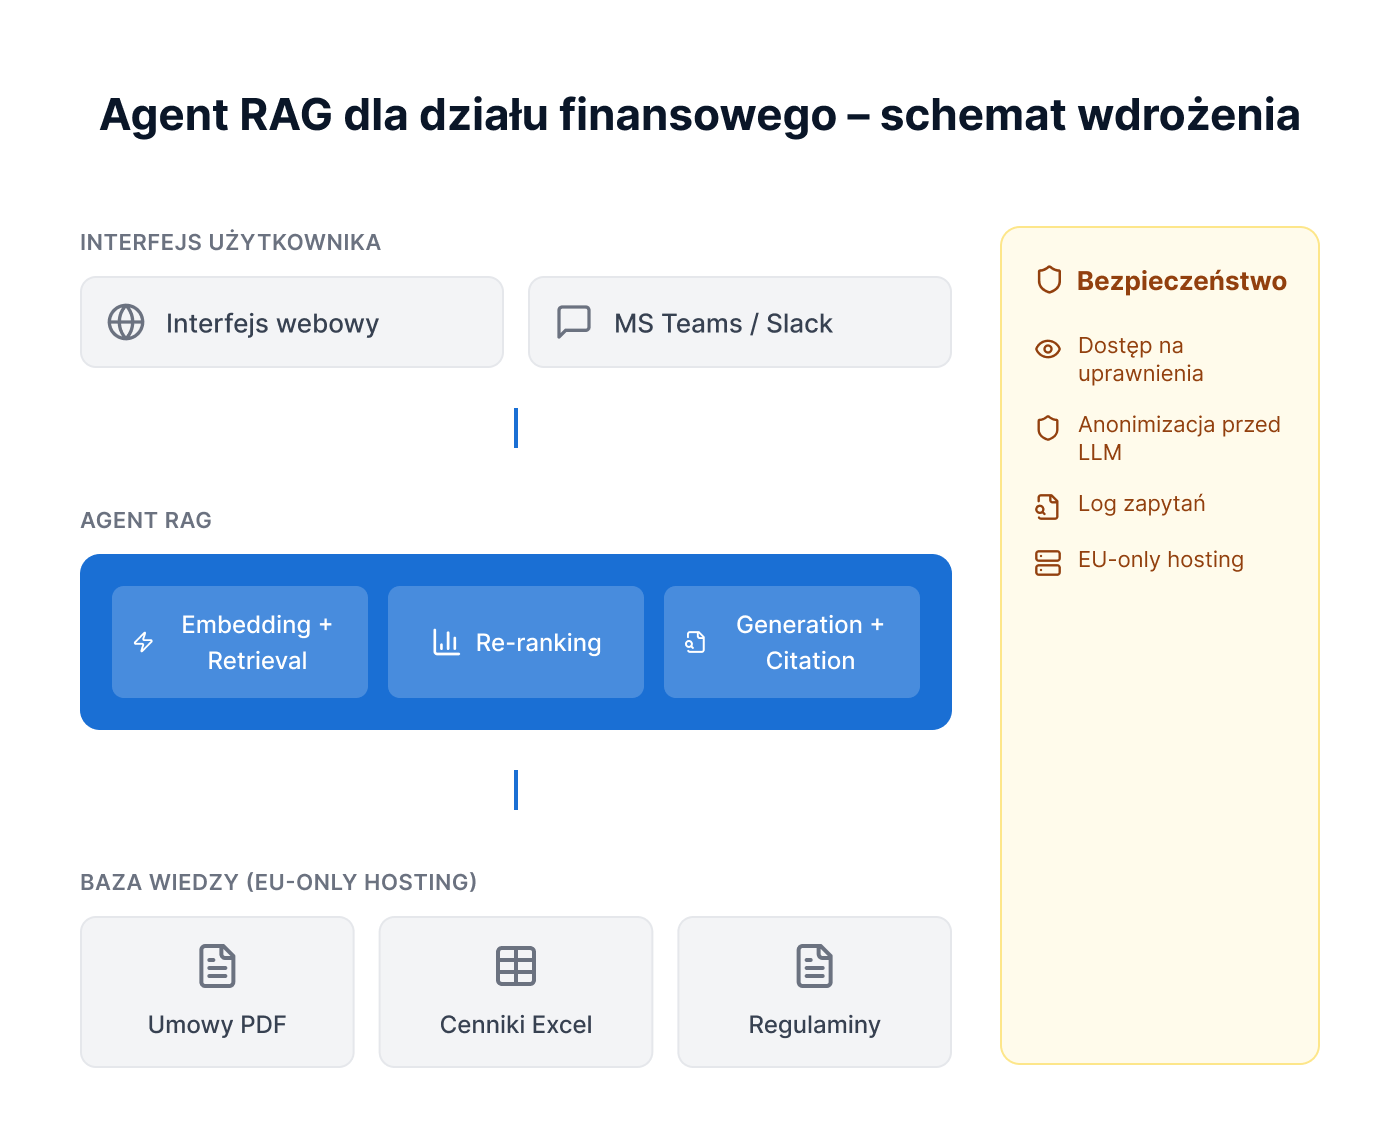
4. Wymagania compliance. Hosting EU-only, anonimizacja przed LLM, pełne logowanie, wymagania AI Act – każde z nich ma cenę w infrastrukturze i czasie wdrożenia.

5. Wymagany poziom autonomii. Agent w trybie „suggest only” kosztuje mniej w konfiguracji i jest bezpieczniejszy w produkcji. Agent działający autonomicznie wymaga więcej reguł, więcej testów i więcej guardrails.

Rynek wrzuca do jednego worka trzy różne produkty: chatbot informacyjny, asystent z wyszukiwaniem wiedzy i agent wykonujący operacje w systemach. To trzy różne poziomy ryzyka, kosztu i odpowiedzialności.

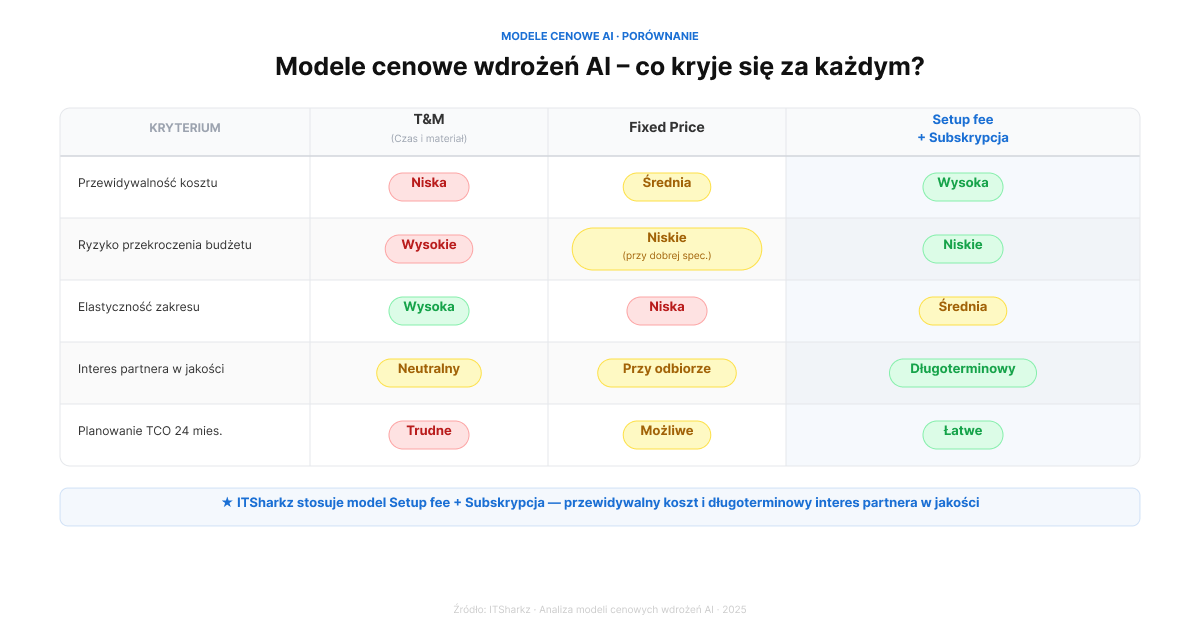
Trzy modele cenowe wdrożeń agentów AI – co kryje się za każdym

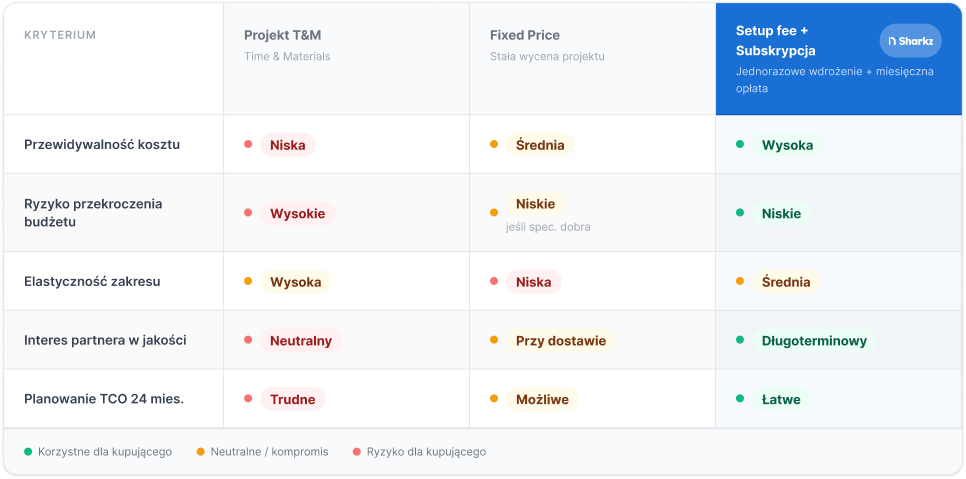
Model 1: Projekt na czas i materiał (T&M)

Płacisz za czas pracy zespołu według stawki godzinowej. Elastyczny, ale trudny do budżetowania. Ryzyko przekroczenia zakresu leży po Twojej stronie.

Na polskim rynku: stawki seniorów AI/backend 180–280 PLN/h netto. Przy projekcie wymagającym 400h pracy – od 72 000 do 112 000 PLN samego kosztu czasu, bez infrastruktury i utrzymania.

Model 2: Fixed price (cena ryczałtowa)

Stała cena za z góry zdefiniowany zakres. Dobre zabezpieczenie budżetowe – pod warunkiem, że specyfikacja jest bardzo precyzyjna przed startem. Każda zmiana zakresu generuje aneks.

Projekt dzieli się na bramki: audyt → MVP → pełne wdrożenie. Po każdym etapie podejmujesz decyzję, czy iść dalej. To najbezpieczniejszy model przy AI, bo największe ryzyko – czy to w ogóle zadziała na Twoich danych – sprawdzasz za 15–25k, zanim zamrozisz sto tysięcy. (Źródło: dokodu.it)

Model 3: Setup fee + subskrypcja miesięczna

Jednorazowy koszt wdrożenia i konfiguracji, następnie miesięczna opłata obejmująca hosting, utrzymanie, monitoring, aktualizacje i wsparcie.

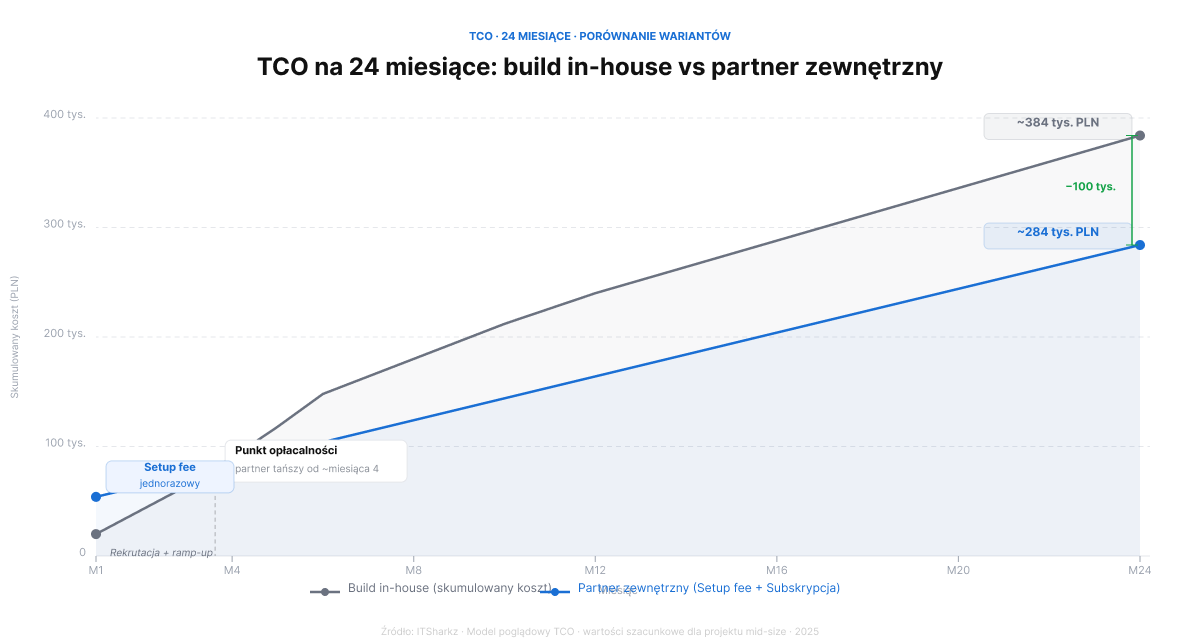
To model, który stosujemy w ITSharkz. Zalety: przewidywalny koszt operacyjny, partner ma interes w tym, żeby system działał dobrze długoterminowo, łatwiejsze planowanie TCO na 24 miesiące. Jeśli wybierasz między zakupem a abonamentem, zobacz pełny rachunek na 3 lata.
Realne widełki cenowe na polskim rynku 2026

Poniższe przedziały cen wdrożeń agentów AI w Polsce opracowaliśmy w ITSharkz na podstawie danych z kilku polskich źródeł rynkowych (LessManual, Syntalith, Algorcomp, PixelAgency – dane z Q1–Q2 2026) oraz własnego doświadczenia wdrożeniowego.

Prosty agent informacyjny (FAQ, knowledge base, jeden system)

  • Setup: 20 000–60 000 PLN
  • Miesięczna subskrypcja: 2 000–5 000 PLN
  • Typowy czas wdrożenia: 4–8 tygodni

Agent procesowy (integracje z 2–3 systemami, obsługa reklamacji, status zamówień)

  • Setup: 40 000–120 000 PLN
  • Miesięczna subskrypcja: 4 000–10 000 PLN
  • Typowy czas wdrożenia: 8–14 tygodni

Agent enterprise (wielosystemowy, złożone reguły, compliance EU)

  • Setup: 100 000–400 000+ PLN
  • Miesięczna subskrypcja: 8 000–25 000+ PLN
  • Typowy czas wdrożenia: 12–24 tygodni

Dla prostego agenta FAQ z jedną bazą wiedzy sensowny próg startu to około 20–60 tys. zł wdrożenia oraz 2–8 tys. zł miesięcznego utrzymania. Jeśli oferta agenta wykonującego akcje w systemach jest podejrzanie tania, zwykle nie wynika to z lepszej technologii. (Źródło: softwarelogic.co)

Ukryte koszty, o których rzadko mówią dostawcy

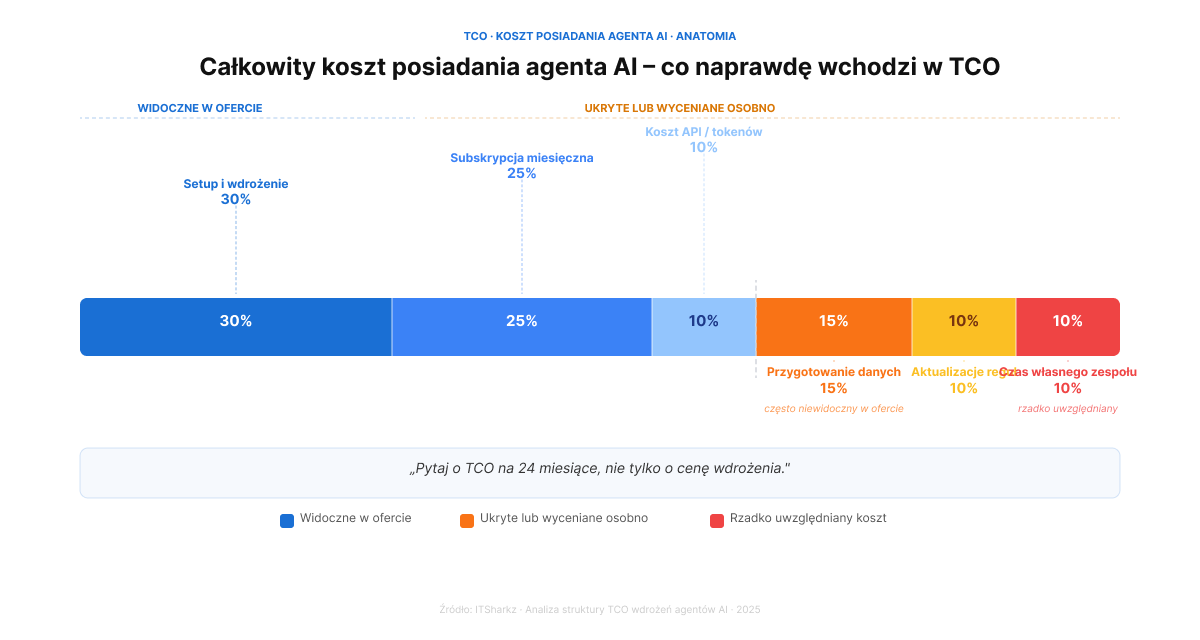
Koszt danych i ich przygotowania. Przygotowanie danych zajmuje od 20 do 40% całkowitego czasu projektu przy nieustrukturyzowanych źródłach. Regularnie nie pojawia się w pierwszej ofercie.

Koszt modeli LLM w czasie. Token cost rośnie z wolumenem. Przy 500 zapytaniach dziennie koszt API może wynosić 200–800 PLN miesięcznie. Ceny API modeli spadają od dwóch lat, ale nadal są zmienną zależną od wolumenu.

Koszt zmian i aktualizacji reguł. Reguły biznesowe ewoluują. Zmiana cennika, nowa procedura, nowa integracja – każda wymaga pracy po stronie agenta. Czy miesięczna subskrypcja to obejmuje, czy to osobna wycena?

Koszt testów regresji po aktualizacjach systemów źródłowych. Jeśli dostawca Twojego ERP wypuści aktualizację, która zmieni format API – agent może przestać działać. Kto odpowiada za testy i naprawę? To powinno być zdefiniowane w umowie.

Koszt własnego czasu i zaangażowania. Discovery workshop, mapowanie procesów, testowanie wyników PoC – realnie od 40 do 100 godzin zaangażowania po stronie klienta przy średnim wdrożeniu.
TCO na 24 miesiące: jak porównywać oferty uczciwie

Cena wdrożenia to tylko jeden wiersz w arkuszu. Uczciwe porównanie ofert wymaga zestawienia TCO na 24 miesiące. Szablon do wypełnienia:

PozycjaOferta AOferta BOferta ITSharkz
Setup fee (jednorazowy)
Subskrypcja mies. × 24
Szacowany koszt API × 24
Przygotowanie danych (est.)
Zmiany i aktualizacje (est.)
➤ Suma TCO 24 mies.

Dwa pytania, które warto zadać każdemu dostawcy:

„Czy mogę zobaczyć przykładową umowę SLA z istniejącym klientem?” – odpowiedź lub jej brak powie więcej o jakości długoterminowego wsparcia niż jakakolwiek prezentacja.

„Kto jest właścicielem kodu i konfiguracji po zakończeniu projektu?” – przy modelach subskrypcyjnych kwestia umowna, którą warto sprawdzić przed podpisaniem.

Setup fee + subskrypcja: dlaczego ITSharkz wybrał ten model

Model T&M: partner zarabia na godzinach. Im więcej godzin, tym wyższy przychód. Interes partnera niekoniecznie jest zbieżny z Twoim interesem w szybkim wdrożeniu.

Fixed price: partner zarabia na zakończeniu projektu. Po odbiorze – jego interes w Twoim sukcesie operacyjnym jest ograniczony.

Setup fee + subskrypcja: partner zarabia tak długo, jak system działa dobrze i klient go używa. Interes partnera jest strukturalnie zbieżny z Twoim – bo rezygnacja klienta jest bezpośrednią stratą finansową partnera.

Dlatego w tym modelu: onboarding jest staranny, monitoring jest proaktywny, a aktualizacje reguł są wbudowane w subskrypcję.

Kiedy taniej jest zbudować in-house, a kiedy nie

Build in-house ma sens gdy:

  • Firma ma dojrzały zespół AI (co najmniej 2–3 seniorów ze stack’iem LLM/agent)
  • Przypadek użycia jest wysoce specyficzny i wymagałby znacznej customizacji każdego zewnętrznego rozwiązania
  • Firma akceptuje 6–18-miesięczny czas do produkcji
  • Jest wewnętrzny właściciel odpowiadający za utrzymanie i ewolucję systemu

Partner zewnętrzny jest lepszym wyborem gdy:

  • Brak wewnętrznego doświadczenia z agentami AI w produkcji
  • Czas do wdrożenia ma znaczenie (4–12 tygodni vs 6–18 miesięcy)
  • System wymaga integracji z wieloma systemami zewnętrznymi
  • Compliance (AI Act, RODO, EU hosting) jest wymaganiem, nie opcją
Podsumowanie

  • Pytaj o TCO na 24 miesiące, nie o cenę wdrożenia. Cena wdrożenia to jeden wiersz w arkuszu. Wybór najtańszego wdrożenia bez uwzględnienia kosztów utrzymania to jeden z najczęstszych błędów przy zakupie AI.
  • Model cenowy partnera mówi o jego motywacjach. Setup fee + subskrypcja jest strukturalnie zbieżna z Twoim interesem. T&M – niekoniecznie.
  • Pytaj o własność kodu i konfiguracji. To pytanie, które warto zadać przed, nie po podpisaniu umowy.

Jeśli chcesz wiedzieć, jak wygląda wdrożenie od warsztatu do produkcji, przeczytaj przewodnik po wdrożeniu automatyzacji AI w firmie. A jeśli interesuje Cię ROI konkretnych zastosowań, zacznij od artykułu o automatyzacji procesów finansowych z AI.

→ Umów bezpłatną rozmowę o wycenie – bez slajdów, z konkretnymi liczbami

Najczęstsze pytania o koszt wdrożenia agenta AI

Ile kosztuje wdrożenie agenta AI w firmie w Polsce? W 2026 roku wdrożenie prostego agenta informacyjnego (FAQ, baza wiedzy, jeden system) to około 20 000–60 000 PLN setupu i 2 000–5 000 PLN miesięcznie. Agent procesowy z integracjami z 2–3 systemami kosztuje 40 000–120 000 PLN plus 4 000–10 000 PLN miesięcznie, a agent enterprise 100 000–400 000+ PLN plus 8 000–25 000+ PLN miesięcznie.

Od czego zależy cena agenta AI? Najbardziej decydują: typ agenta i zakres odpowiedzialności, liczba i charakter integracji z systemami, jakość i dostępność danych, wymagania compliance (hosting w UE, anonimizacja, AI Act) oraz poziom autonomii agenta.

Jakie modele rozliczeń agentów AI są dostępne? Trzy: projekt na czas i materiał (T&M), w którym ryzyko przekroczenia zakresu leży po stronie klienta; fixed price, który wymaga bardzo precyzyjnej specyfikacji; oraz setup fee plus miesięczna subskrypcja obejmująca hosting, utrzymanie i aktualizacje. ITSharkz stosuje trzeci model.

Jakie są ukryte koszty wdrożenia agenta AI? Najczęściej pomijane w ofertach: przygotowanie danych (20–40% czasu projektu przy danych nieustrukturyzowanych), koszt modeli LLM rosnący z wolumenem (np. 200–800 PLN miesięcznie przy 500 zapytaniach dziennie), zmiany reguł biznesowych, testy regresji po aktualizacjach systemów źródłowych oraz własny czas zespołu klienta (40–100 godzin).

Kiedy taniej zbudować agenta AI we własnym zespole? Gdy firma ma dojrzały zespół AI (co najmniej 2–3 seniorów ze stackiem LLM/agent), przypadek użycia jest wysoce specyficzny, akceptuje 6–18 miesięcy do produkcji i ma wewnętrznego właściciela utrzymania. W pozostałych przypadkach lepszy jest partner zewnętrzny: wdrożenie zajmuje wtedy 4–12 tygodni.

Jak uczciwie porównać oferty na agenta AI? Zestawiając TCO na 24 miesiące (setup, subskrypcja × 24, koszt API, przygotowanie danych, zmiany) oraz pytając każdego dostawcę o przykładową umowę SLA z istniejącym klientem i o własność kodu i konfiguracji po zakończeniu projektu.
Automatyzacja AI w logistyce i e-commerce – gdzie jest największy ROI?

Logistyka i e-commerce to branże z największą liczbą powtarzalnych procesów spośród wszystkich sektorów polskiej gospodarki. Obsługa zamówień, reklamacje, aktualizacje stanów magazynowych, komunikacja z kurierami, generowanie dokumentów przewozowych – każdy z tych procesów jest wykonywalny przez człowieka, powtarzalny i oparty na regułach.

To znaczy, że każdy z nich nadaje się do automatyzacji.

DHL E-Commerce Trends Report 2025 wskazuje automatyzację i AI jako jedne z kluczowych technologii wpływających na przyszłość e-commerce – szczególnie w obszarze logistyki, dostawy i obsługi klienta. Firmy inwestujące w te rozwiązania postrzegają je jako niezbędne do utrzymania konkurencyjności.

Ten artykuł mapuje konkretne procesy na konkretne przypadki użycia agentów AI i pokazuje, gdzie ROI jest najwyższy – i gdzie go nie ma.

Gdzie logistyka i e-commerce tracą czas na procesy manualne

W rozmowach z firmami z sektora e-commerce i logistyki regularnie pojawia się ten sam zestaw bottlenecków:

Obsługa zapytań o status zamówienia. W większości sklepów internetowych od 30 do 50% wszystkich kontaktów klientów dotyczy jednego pytania: „Gdzie jest moje zamówienie?” Każde takie zapytanie angażuje konsultanta, który mógł wygenerować odpowiedź automatycznie.

Ręczna obsługa reklamacji i zwrotów. Reklamacja wymaga weryfikacji zamówienia, sprawdzenia historii zakupów, oceny zasadności, podjęcia decyzji, wygenerowania dokumentu i komunikacji z klientem. W większości firm każdy krok jest osobną czynnością wykonywaną ręcznie.

Aktualizacje stanów magazynowych. Przy sprzedaży wielokanałowej synchronizacja stanów jest powtarzalna, krytyczna i błędogenna przy manualnym podejściu. Każda rozbieżność generuje anulowania zamówień lub sprzedaż towarów, których nie ma.

Generowanie dokumentów logistycznych. Listy przewozowe, awiza, potwierdzenia odbioru – generowane ręcznie przez osoby, które mogłyby robić coś innego.

Raport E-commerce w Polsce 2025 potwierdza, że ponad połowa badanych (53%) korzysta z narzędzi AI w procesie zakupowym. 80% opisuje doświadczenia z chatbotami jako pozytywne lub neutralne, ale nie wybiera tej formy jako preferowanej – co oznacza, że agent AI rozwiązujący problem jest inną kategorią niż chatbot oparty na regułach.

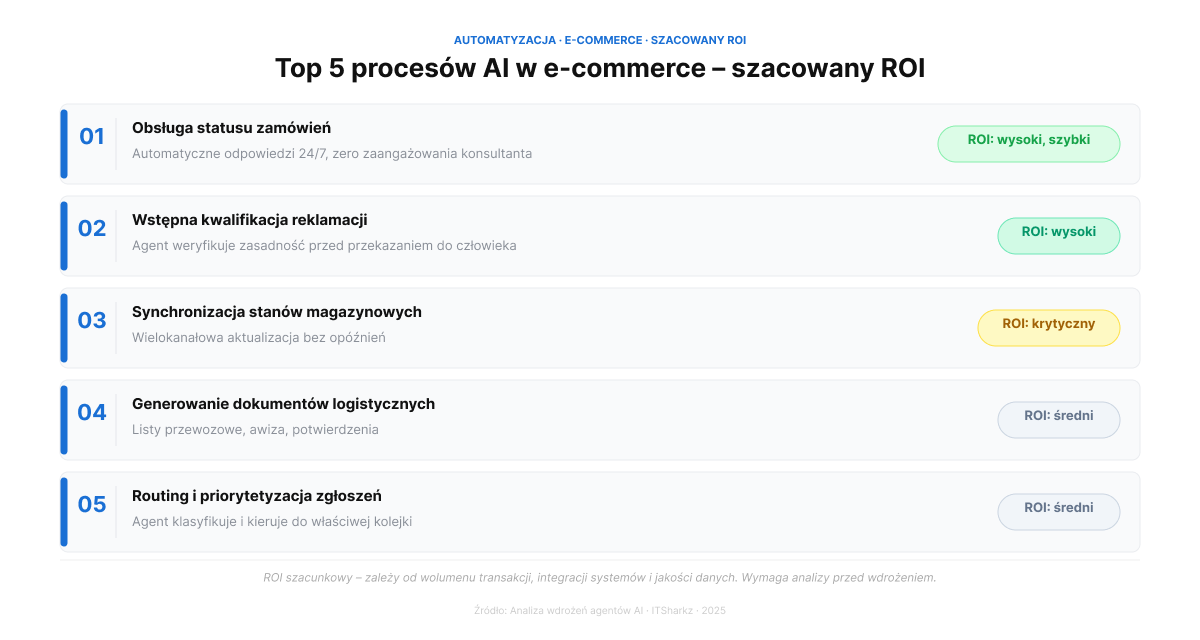
Top 5 procesów do automatyzacji AI w e-commerce

1. Obsługa statusu zamówienia i śledzenia przesyłki

Najwyższy wolumen, najniższa złożoność decyzji. Idealny punkt startowy dla agenta AI.

Agent pobiera numer zamówienia od klienta (e-mail, chat, WhatsApp), odpytuje system OMS i API przewoźnika, zwraca aktualny status z szacowaną datą dostawy. Jeśli przesyłka jest opóźniona – agent informuje proaktywnie i eskaluje do człowieka tylko przy problemach wymagających decyzji.

Typowy efekt: eliminacja 40–60% wolumenu kontaktów z obsługą klienta dotyczących statusu zamówień.

2. Wstępna kwalifikacja i obsługa reklamacji

Reklamacja trafia do agenta. Agent weryfikuje zamówienie, sprawdza historię zakupów i płatności, ocenia zgłoszenie według zdefiniowanych reguł, generuje wstępną decyzję i proponuje rozwiązanie (wymiana, zwrot, bon).

Człowiek widzi tylko przypadki niestandardowe lub wykraczające poza reguły. Przy dobrze skonfigurowanych regułach – od 30 do 50% całego wolumenu reklamacji obsługuje agent samodzielnie.

3. Synchronizacja stanów magazynowych wielokanałowa

Agent monitoruje stany magazynowe w czasie rzeczywistym i synchronizuje je między platformami sprzedażowymi. Przy spadku stanu poniżej progu – generuje alert zakupowy lub automatycznie wstrzymuje sprzedaż na wybranych kanałach.

To jeden z nielicznych obszarów, gdzie brak automatyzacji generuje bezpośredni koszt finansowy w postaci anulowań zamówień i kar od platform.

4. Generowanie dokumentów logistycznych

Listy przewozowe, etykiety, awiza dostaw, potwierdzenia odbioru – generowane automatycznie na podstawie danych zamówienia, bez manualnego przepisywania.

5. Routing i priorytetyzacja zgłoszeń serwisowych

Agent klasyfikuje przychodzące zgłoszenia według kategorii, pilności i wartości klienta, przypisuje do właściwej kolejki i agenta. Pierwsze odpowiedzi dla typowych kategorii – automatyczne.

Agent AI w obsłudze reklamacji – jak skrócić czas rozwiązania

Reklamacje to jeden z procesów, gdzie ROI z agenta AI jest najłatwiej mierzalny – bo czas rozwiązania reklamacji ma bezpośrednie przełożenie na satysfakcję klienta i koszty operacyjne.

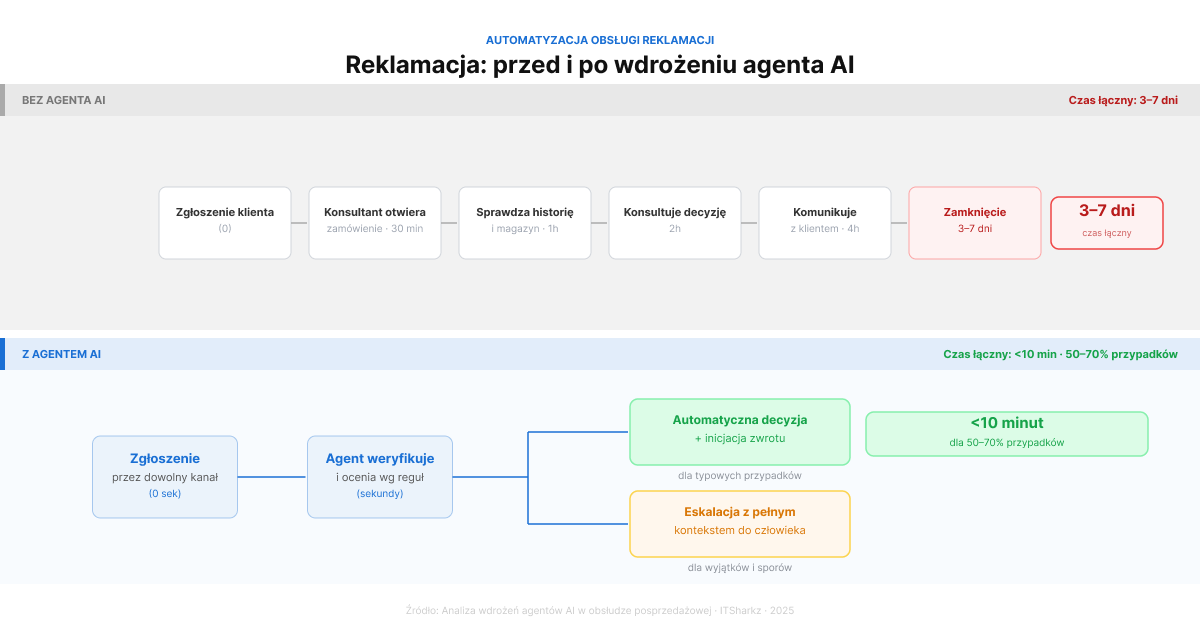
Klasyczny przepływ manualny: klient zgłasza reklamację → konsultant otwiera zamówienie → sprawdza historię → konsultuje z magazynem → podejmuje decyzję → komunikuje z klientem. Przy dużym wolumenie: czas rozwiązania 3–7 dni.

Przepływ z agentem AI: klient zgłasza przez dowolny kanał → agent weryfikuje dane w czasie rzeczywistym → ocenia zasadność według reguł → dla typowych przypadków: automatyczna decyzja i inicjacja procesu → dla niejednoznacznych: eskalacja z pełnym kontekstem.

Typowy efekt wdrożenia: czas rozwiązania standardowych reklamacji skraca się z dni do minut. Koszt obsługi na reklamację spada o 40–70% przy zachowaniu lub poprawie jakości.

Sprawdź, jak ITSharkz wdraża agentów AI.

Integracja agenta AI z systemami WMS, ERP i platformami sprzedażowymi

Skuteczność agenta AI w logistyce zależy od jakości integracji z systemami źródłowymi. Kluczowe integracje:

OMS (Order Management System) – status zamówień, historia zakupów, wartość klienta. Niezbędne dla obsługi statusu i reklamacji.

WMS (Warehouse Management System) – aktualne stany magazynowe, lokalizacje produktów, progi uzupełnień. Niezbędne dla synchronizacji wielokanałowej.

API przewoźników (InPost, DPD, DHL, GLS) – śledzenie przesyłek w czasie rzeczywistym. Niezbędne dla proaktywnej komunikacji o opóźnieniach.

Platformy sprzedażowe (Allegro, Amazon, własny sklep) – stany i zamówienia z każdego kanału. Krytyczne przy sprzedaży wielokanałowej.

CRM / helpdesk – historia interakcji, profil klienta, poprzednie reklamacje. Niezbędne dla kontekstu przy eskalacjach.

Jedno ostrzeżenie: integracja z wieloma systemami jednocześnie bezpośrednio wpływa na czas i koszt wdrożenia. Dobry PoC zaczyna się od jednej integracji (np. OMS + API przewoźnika), mierzy efekt i dopiero potem rozszerza zakres.

Gdzie automatyzacja AI NIE przynosi ROI w logistyce

Procesy wymagające fizycznej interwencji. Agent AI zarządza informacją – nie może fizycznie przepakować zwrotu, oznaczyć uszkodzonego towaru ani wykonać inwentaryzacji.

Niestandardowe przypadki bez precedensu. Agent działa najlepiej na regułach i historycznych wzorcach. Reklamacja z unikalną kombinacją okoliczności powinna trafić do człowieka – i to jest właściwe zachowanie.

Decyzje wymagające osądu relacyjnego. Klient VIP z długą historią zgłasza reklamację, która technicznie nie spełnia kryteriów. Decyzja, czy wyjść poza reguły – to jest decyzja człowieka.

Wolumen poniżej progu. Przy mniej niż 100–150 reklamacjach lub zapytaniach miesięcznie koszt wdrożenia agenta trudno uzasadnić ekonomicznie.

Jak zaplanować pilotaż w 4 tygodnie

Tydzień 1: Wybór procesu i audyt danych. Jeden proces (rekomendowany start: obsługa statusu zamówień lub wstępna kwalifikacja reklamacji), pomiar aktualnego wolumenu i czasu obsługi, ocena dostępności API systemów źródłowych.

Tydzień 2: Konfiguracja i pierwsza integracja. Agent połączony z jednym systemem (np. OMS), pierwsze testy na danych historycznych, konfiguracja reguł dla typowych przypadków.

Tydzień 3–4: PoC na realnym wolumenie. Agent pracuje na prawdziwych zgłoszeniach w trybie „suggest only”. Kalibracja reguł na podstawie korekt konsultantów.

Po PoC: Raport i decyzja. Procent przypadków obsłużonych poprawnie, czas obsługi przed i po, liczba eskalacji. Na tej podstawie: decyzja o pełnym wdrożeniu lub korekcie zakresu.

Pełną metodologię wdrożenia znajdziesz w przewodniku po wdrożeniu automatyzacji AI w firmie.

Podsumowanie

  • Zacznij od obsługi statusu zamówień lub reklamacji – najwyższy wolumen, najniższa złożoność, najszybszy ROI. Nie od synchronizacji WMS z pięcioma platformami jednocześnie.
  • Agent AI działa na regułach i danych – jakość integracji z OMS, WMS i API przewoźników decyduje o skuteczności bardziej niż wybór modelu LLM.
  • ROI jest mierzalny w tygodniach, nie kwartałach – czas obsługi reklamacji, wolumen kontaktów do konsultantów, procent automatycznie zamkniętych zgłoszeń to metryki policzalne od pierwszego dnia PoC.

→ Omów automatyzację operacji e-commerce z ITSharkz

AI Act a wdrożenia agentów AI w Polsce – co musi wiedzieć każda firma przed startem

Większość polskich firm wdrażających agentów AI w 2026 roku nie wie, do której kategorii ryzyka należy ich system. Nie dlatego, że kwestia jest niejasna. Dlatego, że nikt tego nie sprawdził.

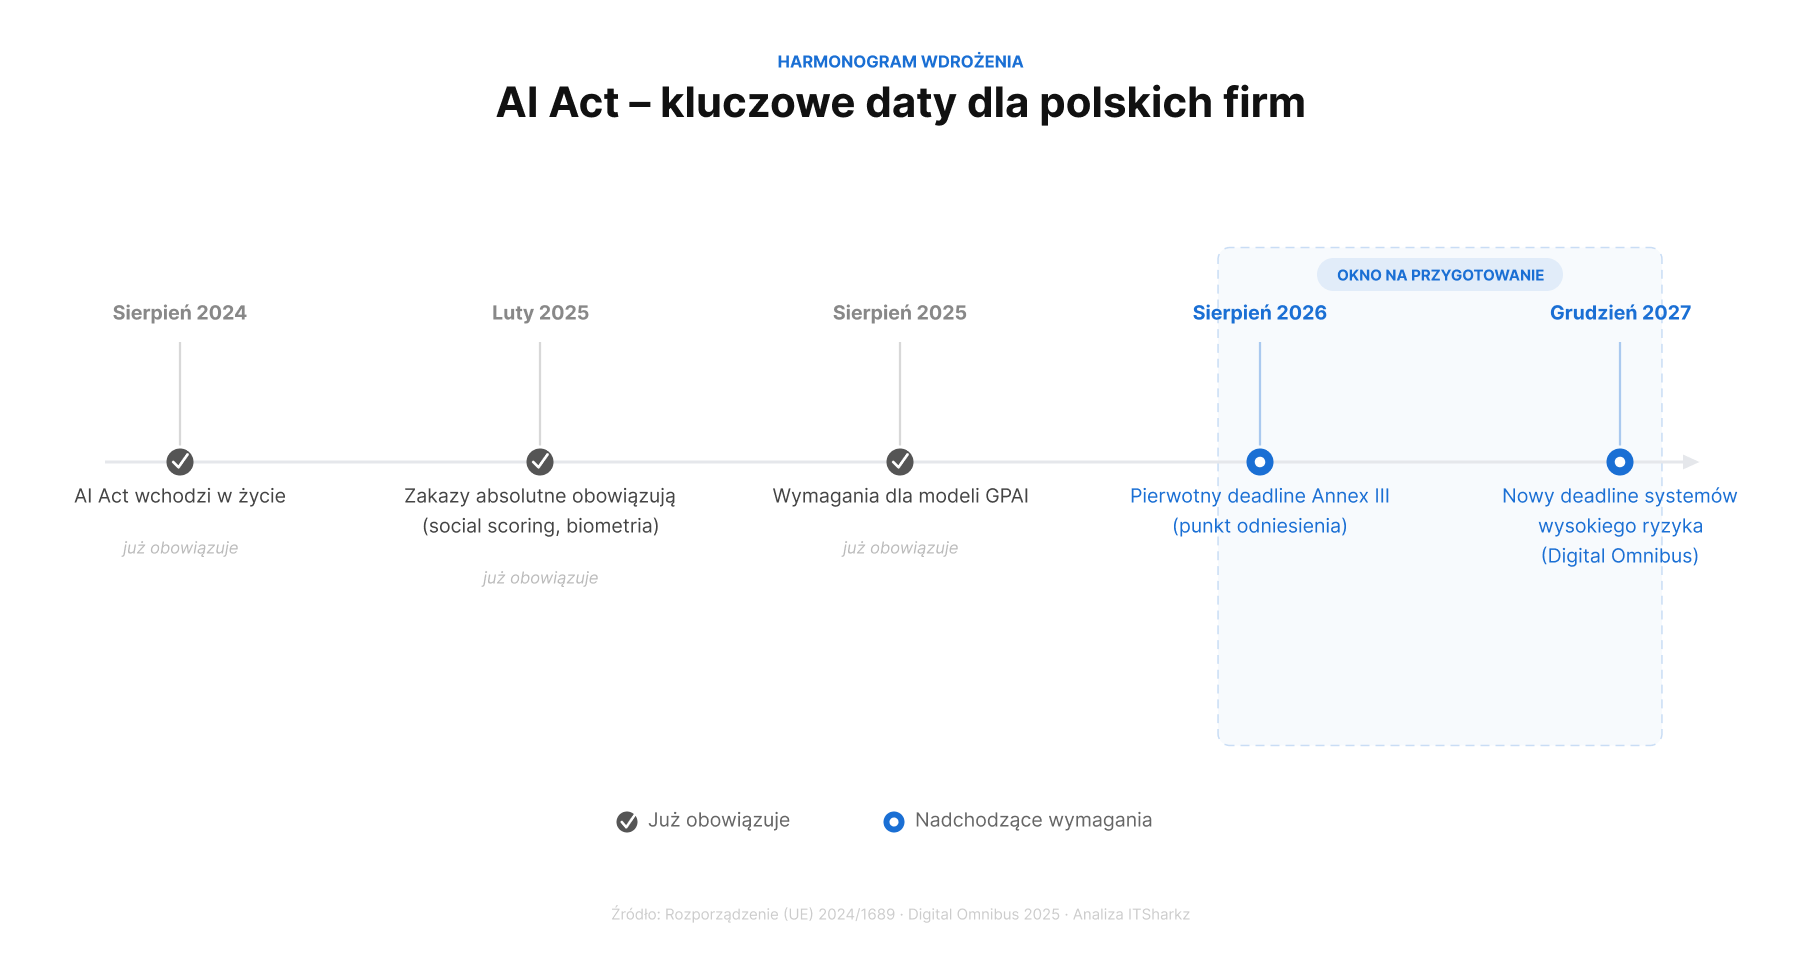
AI Act to nie przyszłość – to teraźniejszość. Zakazy absolutne obowiązują od lutego 2025, wymagania dla modeli AI ogólnego przeznaczenia od sierpnia 2025. Pełna egzekucja systemów wysokiego ryzyka wystartowała 2 sierpnia 2026. A według Capgemini TechnoVision 2026, większość europejskich firm wciąż nie przeprowadziła klasyfikacji swoich systemów AI.

Ten artykuł nie jest przeglądem prawa. Jest odpowiedzią na pytanie, które zadają dyrektorzy IT, compliance officerzy i właściciele firm przed kolejnym wdrożeniem: co konkretnie AI Act oznacza dla agenta AI, który chcemy uruchomić, i co musimy mieć, żeby działać zgodnie z przepisami.

Co AI Act zmienia dla firm wdrażających agentów AI w 2026 roku

Kluczowe jest rozróżnienie ról. AI Act rozróżnia dwie pozycje, które mają fundamentalnie inne obowiązki:

Dostawca (provider) – firma, która tworzy lub wprowadza system AI na rynek. Jeśli ITSharkz buduje agenta AI dla klienta – ITSharkz jest dostawcą w rozumieniu rozporządzenia.

Podmiot stosujący (deployer) – firma, która wdraża i używa systemu AI w swojej działalności. Klient, który uruchamia agenta AI do obsługi faktur lub rekrutacji – to podmiot stosujący.

W praktyce firmy wdrażające AI dla siebie mogą pełnić obie role jednocześnie.

Sankcje w AI Act są surowsze niż te znane z RODO. Za stosowanie zakazanych praktyk AI grozi do 35 mln EUR lub 7% globalnego obrotu. Za niespełnienie wymogów dla systemów wysokiego ryzyka kara może wynieść do 15 mln EUR lub 3% obrotu.

Digital Omnibus przesunął obowiązki dla systemów wysokiego ryzyka: do 2 grudnia 2027 r. dla systemów wskazanych w AI Act, do 2 sierpnia 2028 r. dla systemów objętych regulacjami sektorowymi. To nie jest powód do zwlekania – to okno na zbudowanie właściwej architektury.

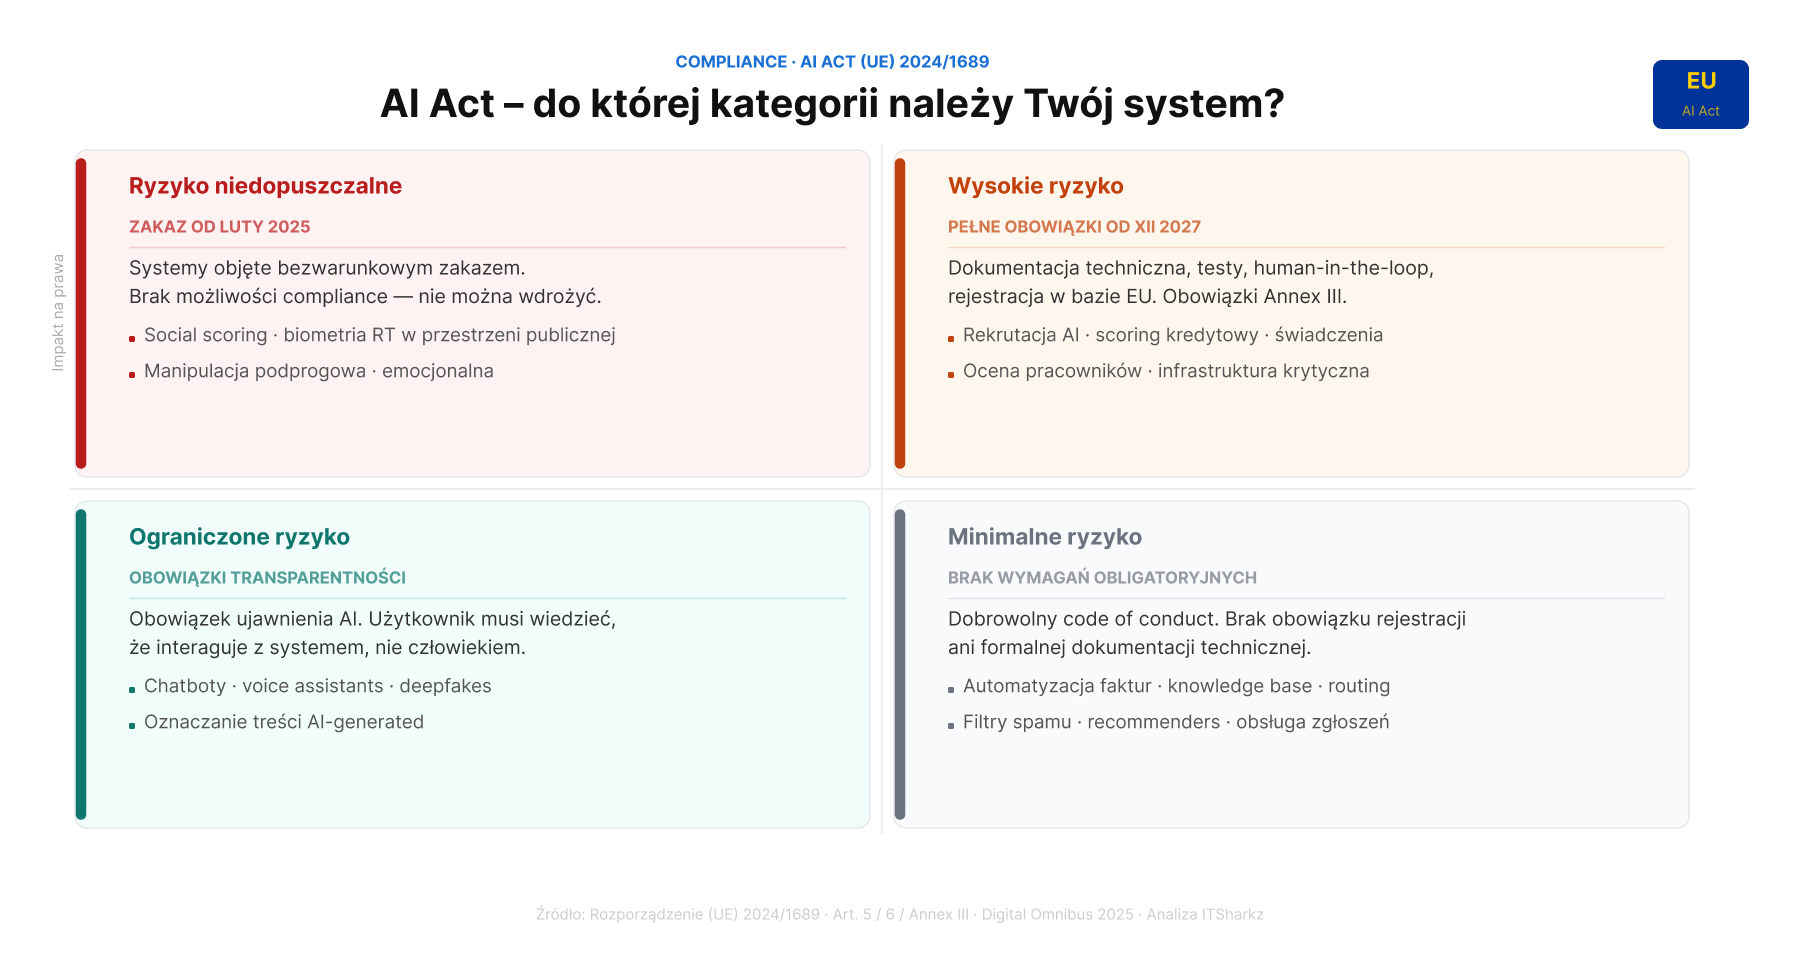
Kategorie ryzyka: gdzie prawdopodobnie trafia Twój system AI

Ryzyko niedopuszczalne (zakaz bezwzględny)

Systemy zakazane od lutego 2025. Dotyczą wąskiego zakresu zastosowań, które większości firm nie dotyczy: social scoring, biometryczna identyfikacja w czasie rzeczywistym w przestrzeni publicznej, rozpoznawanie emocji w miejscu pracy, manipulacja behawioralna.

Wysokie ryzyko (Annex III)

Dla polskich firm szczególnie istotne są trzy kategorie: zatrudnienie (selekcja CV, ranking kandydatów, ocena wydajności), finanse i usługi esencjonalne (scoring kredytowy, ocena zdolności ubezpieczeniowej), edukacja (decyzje o przyjęciach, egzaminach, ocenianiu).

Jeśli Twój agent AI wspiera decyzje kadrowe, kredytowe lub dotyczące dostępu do świadczeń – jesteś w tej kategorii.

Ograniczone ryzyko (transparency)

Chatboty i systemy generujące treść. Wymogi dotyczą głównie transparentności: informowania, że użytkownik ma do czynienia z AI, oraz oznaczania treści jako wygenerowanych.

Minimalne ryzyko (brak obowiązków)

Zdecydowana większość agentów AI wdrażanych przez polskie firmy: automatyzacja faktur, knowledge management, obsługa zgłoszeń serwisowych, asystent wewnętrzny HR. Brak obowiązkowych wymagań – choć dobre praktyki warto stosować niezależnie od kategorii.

Wymagania obowiązkowe: nadzór człowieka, traceability, dokumentacja

Human-in-the-loop – w architekturze, nie w polityce

Nadzór człowieka musi być możliwy technicznie: agent musi umożliwiać monitorowanie, rozumienie i nadpisanie swojej decyzji. Dokument mówiący „pracownicy weryfikują wyniki AI” nie spełnia tego wymogu. System musi mieć zbudowany mechanizm override, ścieżkę eskalacji i interfejs pozwalający na interwencję.

Traceability – logi od pierwszego dnia

W przypadku systemów AI wysokiego ryzyka obowiązuje przygotowanie szczegółowej dokumentacji technicznej, stworzenie procedury testowania oraz udokumentowanie oceny ryzyka.

Każda decyzja, każde wejście, każde wyjście – zlogowane automatycznie, z identyfikatorem użytkownika i znacznikiem czasu. Nie próbkowane. Nie włączane reaktywnie. Zawsze.

Dokumentacja techniczna – przed wdrożeniem

Dokumentacja musi istnieć przed uruchomieniem systemu: cel przeznaczenia, proces zarządzania ryzykiem, governance danych treningowych, benchmarki dokładności i odporności.

Rejestracja w bazie EU

Od 2 sierpnia 2026 roku dla systemów wysokiego ryzyka obowiązkowe jest zarejestrowanie systemu w bazie EU. (Dla systemów objętych Digital Omnibus – deadline grudzień 2027.)

RODO + AI Act: gdzie się przecinają

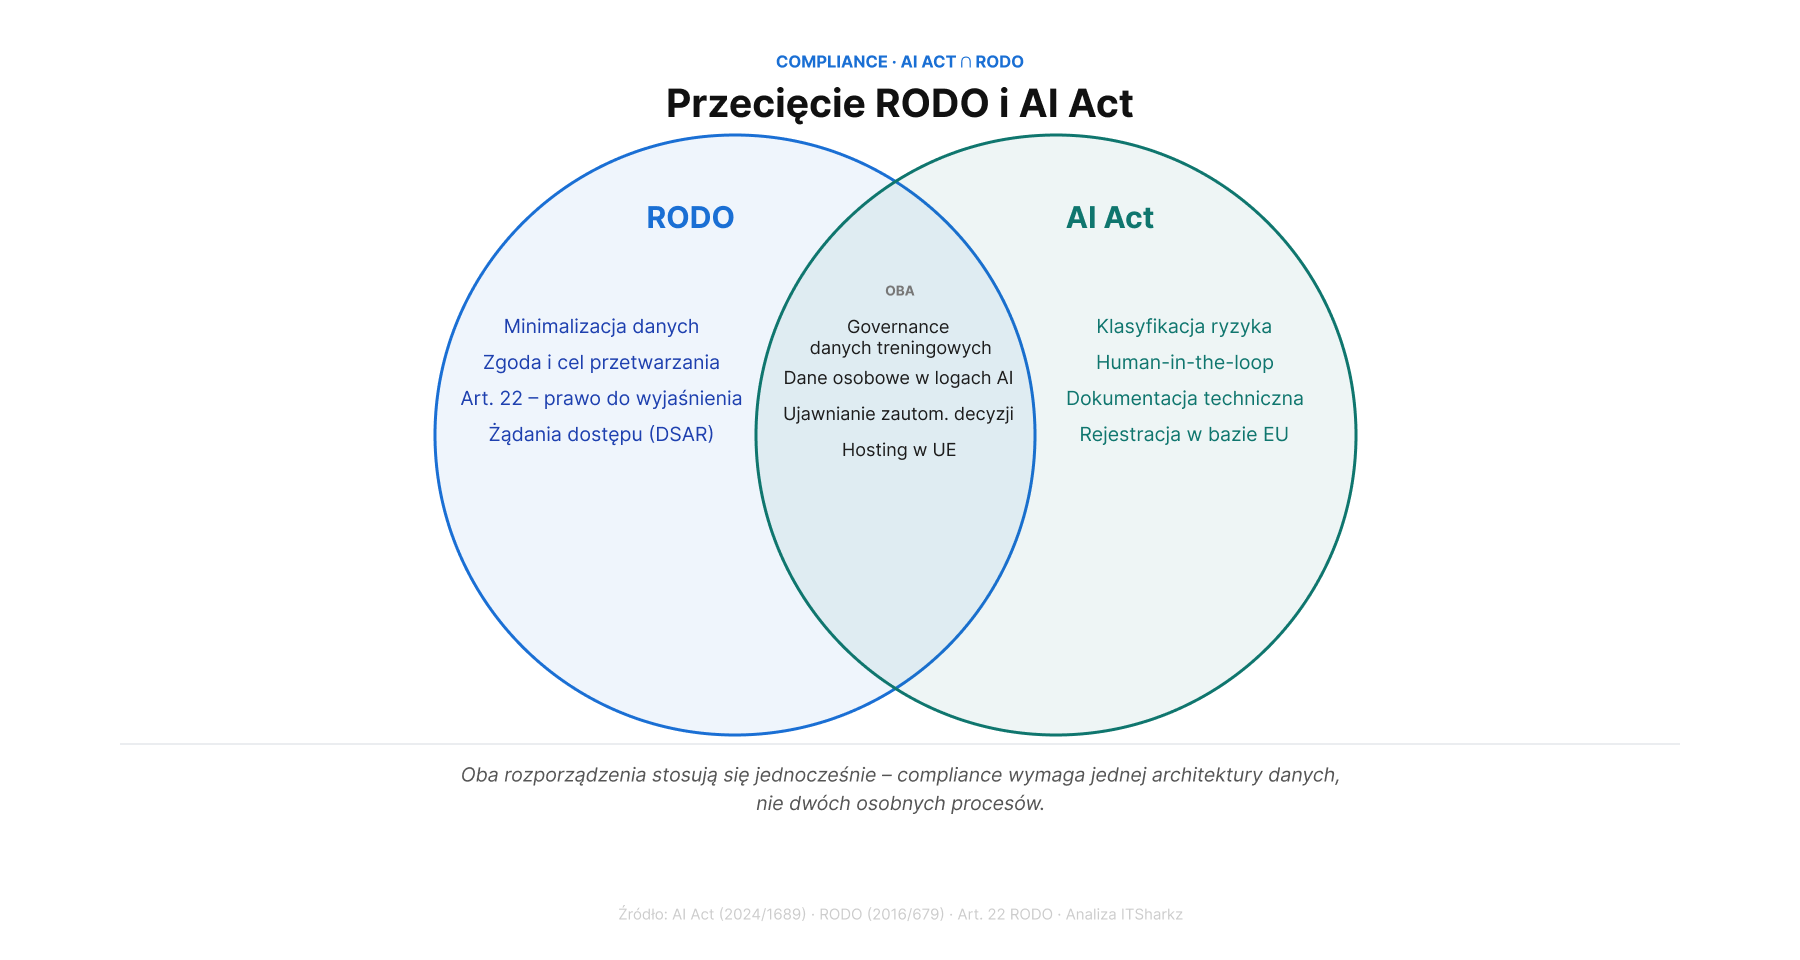
To nie są dwa osobne problemy compliance. Stosują się jednocześnie do tej samej warstwy danych – i to przecięcie jest miejscem, gdzie większość zespołów wdraża się nieświadomie w ryzyko.

Dane treningowe a minimalizacja. RODO wymaga zbierania danych tylko do określonego celu. Trenowanie lub fine-tuning modelu na historycznych danych pracowniczych lub klientów tworzy cel wtórny wymagający oceny podstawy prawnej.

Automatyczne decyzje (art. 22 RODO). Prawo do niepodlegania wyłącznie zautomatyzowanym decyzjom o znacznych skutkach prawnych obowiązuje już teraz. Jeśli agent AI materialnie wpływa na decyzje kadrowe, kredytowe lub o dostępie do usług – ten przepis ma zastosowanie.

DSARy a logi decyzji AI. Jeśli logi systemu AI zawierają dane osobowe, podlegają żądaniom dostępu do danych. Architektura retencji i dostępu musi to uwzględniać przed wdrożeniem.

Hosting w UE jako element architektury compliance

RODO i AI Act nie wymagają wprost hostingu w UE we wszystkich przypadkach – ale dla systemów przetwarzających dane osobowe i wrażliwe, hosting EU-only jest domyślnie bezpiecznym wyborem architektonicznym.

Praktyczne pytanie: czy możemy przedstawić certyfikat rezydencji danych potwierdzający, że każdy bajt danych osobowych pozostał w EOG w trakcie przetwarzania?

Przy ITSharkz domyślnie hostujemy na infrastrukturze EU-only (OVHcloud, Scaleway, Genesis Cloud) z dokumentacją rezydencji danych. To nie jest nadbudówka compliance – to wybór projektowy od pierwszego sprintu.

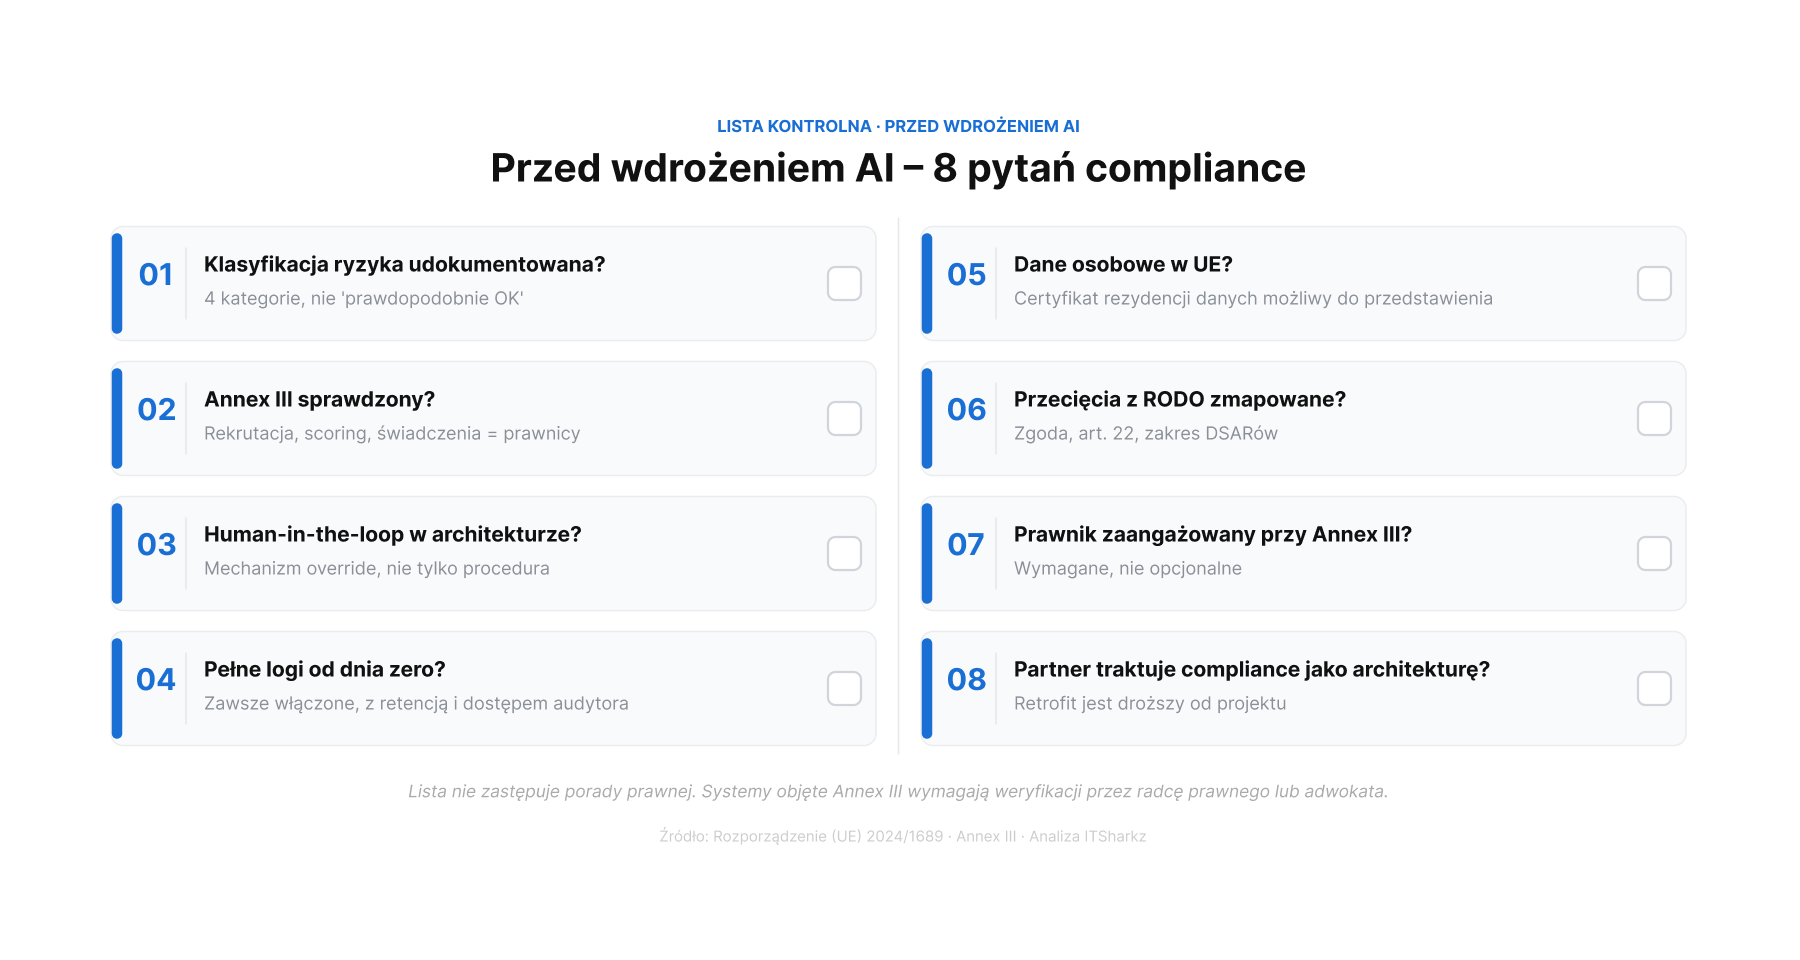
Checklist przed wdrożeniem: 8 pytań, które powinien zadać każdy zamawiający

Podsumowanie

AI Act nie jest przepisem na przyszłość. Jest regulacją obowiązującą – etapowo, ale realnie – już teraz.

  • Zdecydowana większość agentów AI – automatyzacja faktur, knowledge management, asystent HR – należy do kategorii minimalnego ryzyka. Klasyfikacja jest jednak obowiązkiem, nie opcją.
  • Systemy wysokiego ryzyka mają dodatkowy czas (Digital Omnibus przesunął deadline na grudzień 2027) – ale dokumentacja i architektura oversight nie da się zbudować w sprincie.
  • Compliance to decyzja architektoniczna, nie prawna. Human-in-the-loop, traceability i EU hosting zaprojektowane od pierwszego sprintu są szybsze i tańsze niż retrofitting.

Jeśli chcesz zobaczyć, jak architektura compliance wygląda w praktyce, przeczytaj przewodnik po wdrożeniu automatyzacji AI w firmie. A jeśli interesuje Cię aspekt bezpieczeństwa danych przy systemach opartych na RAG, sprawdź artykuł o RAG i danych firmowych.

Sprawdź, czy Twoje wdrożenie AI spełnia wymogi → https://itsharkz.com/pl/ai-agents/

Automatyzacja procesu ofertowania z AI – jak skrócić czas odpowiedzi z tygodni do jednego dnia

Firmy B2B tracą kontrakty z powodu wolnego procesu ofertowania znacznie częściej, niż wynika to z ich CRM. W systemie pojawia się zapis „klient wybrał inną ofertę” – ale prawdziwy powód jest często inny: odpowiedź przyszła za późno.

Według raportu Loopio 2025 RFP Trends & Benchmarks, 68% zespołów ofertowych używało generatywnej AI w procesie odpowiedzi na RFP w ciągu ostatniego roku – około dwa razy więcej niż rok wcześniej. Firmy, które nie wdrożyły automatyzacji, nie stoją w miejscu. Tracą pozycję.

Ten artykuł odpowiada na pytania, które zadają dyrektorzy handlowi i właściciele firm przed decyzją: co konkretnie automatyzuje agent AI w procesie ofertowania, ile czasu i pieniędzy to oszczędza, kiedy wdrożenie ma sens – i kiedy nie.


Gdzie ofertowanie traci czas i pieniądze

Zanim przejdziemy do rozwiązań, warto zmierzyć problem.

Przeciętna firma B2B z aktywnym działem sprzedaży przetwarza od kilkunastu do kilkudziesięciu zapytań ofertowych miesięcznie. Każde wymaga zebrania danych z różnych miejsc: historycznych projektów, cenników, specyfikacji technicznych, wycen od podwykonawców, danych z CRM.

Przy ręcznym procesie ten etap zajmuje od kilku godzin do kilku dni na ofertę. Według raportu Loopio 2025, średni czas przygotowania jednego zapytania ofertowego wynosił 25 godzin – i to w firmach, które miały już zorganizowane procesy.

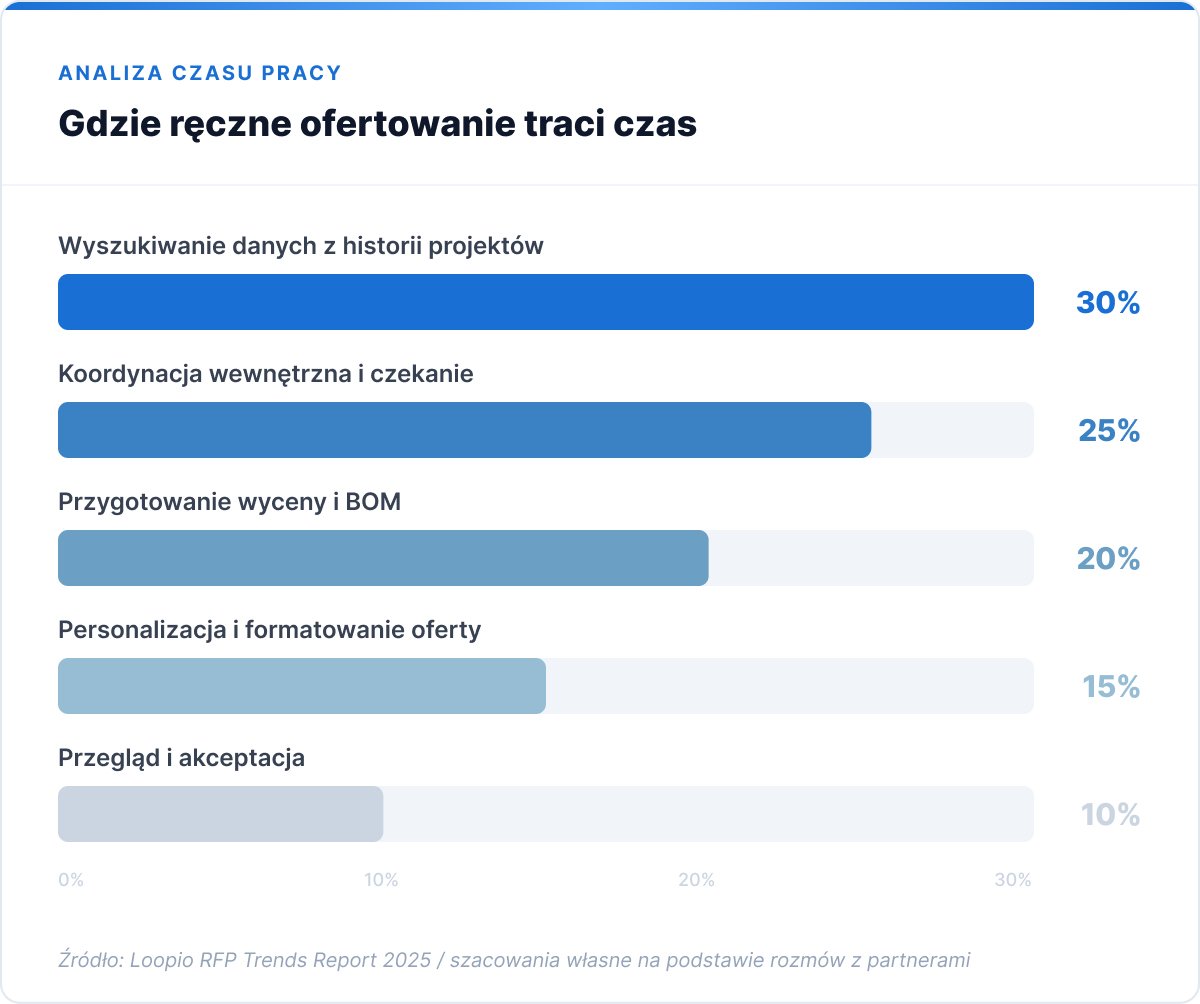
Trzy miejsca, gdzie ofertowanie traci czas najbardziej:

Wyszukiwanie danych z poprzednich projektów. Handlowiec wie, że firma robiła podobny projekt rok temu. Nie pamięta, gdzie są pliki. Spędza godzinę na SharePoincie, pyta kolegów, dostaje folder z połową dokumentacji. Przy każdym nowym zapytaniu – od nowa.

Koordynacja wewnętrzna. Oferta techniczna wymaga wkładu od działu inżynieryjnego. Dział inżynieryjny jest zajęty. Handlowiec czeka 3 dni na wycenę podzespołów. Klient w tym czasie rozmawia z konkurentem.

Formatowanie i personalizacja. Oferta gotowa merytorycznie, ale trzeba ją dopasować do formatu klienta, dodać referencje z podobnych projektów, przygotować stronę tytułową. Kolejne 2-3 godziny pracy.

Każda z tych czynności jest powtarzalna. Każda bazuje na danych, które firma już posiada. I każda nadaje się do automatyzacji.

Co robi agent AI w procesie ofertowania

Agent AI do ofertowania to nie szablon dokumentu z automatycznym wypełnianiem. To system, który wykonuje sekwencję działań: pobiera zapytanie, przeszukuje własne bazy danych firmy, generuje wstępny draft z podaniem źródeł każdej pozycji i przekazuje człowiekowi do weryfikacji i finalizacji.

Kluczowe wyróżnienie: agent pracuje wyłącznie na danych firmy. Nie generuje liczb z modelu językowego. Nie wymyśla cen ani specyfikacji. Wyciąga je z historycznych projektów, cenników, baz kosztowych i systemów ERP – i wskazuje konkretne źródło każdej pozycji.

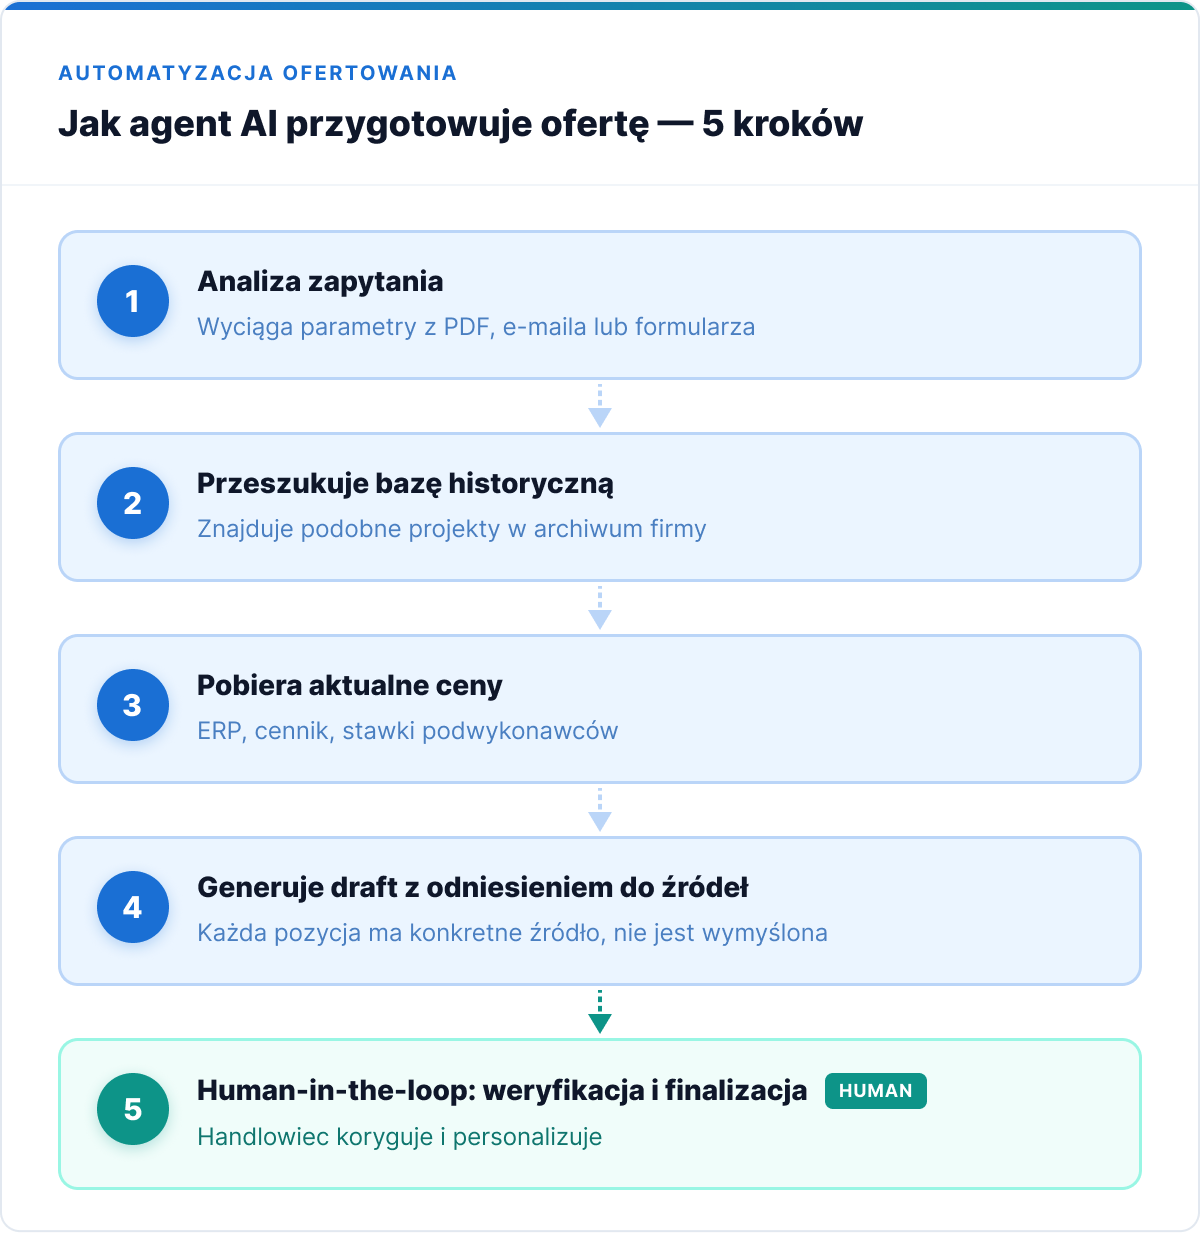
W praktyce sekwencja wygląda następująco:

Krok 1: Analiza zapytania Agent wczytuje dokument zapytania (PDF, e-mail, formularz z portalu) i wyciąga kluczowe parametry: zakres prac, specyfikacje techniczne, termin realizacji, wymagania formalne.

Krok 2: Wyszukiwanie w bazie historycznej Agent przeszukuje archiwum poprzednich projektów pod kątem podobnych parametrów: zbliżony zakres, branża, skala. Wyciąga dane kosztowe i strukturę wycen z projektów referencyjnych.

Krok 3: Pobranie aktualnych cen Agent odpytuje system ERP lub bazę cennikową o aktualne ceny komponentów, stawki roboczogodziny, koszty podwykonawców.

Krok 4: Generowanie draftu Agent produkuje strukturę oferty z wypełnionymi pozycjami kosztowymi, odwołaniami do źródeł i propozycją referencji. Handlowiec widzi nie gotową ofertę do wysłania, lecz gotowy materiał roboczy do weryfikacji i personalizacji.

Krok 5: Human-in-the-loop Człowiek weryfikuje, koryguje, dopasowuje argumentację do specyfiki klienta i zatwierdza. Czas tej fazy: 1-2 godziny zamiast 2-3 dni zbierania danych.

Jeśli chcesz zrozumieć, jak agent AI uczy się z danych firmowych od strony technicznej, przeczytaj artykuł o architekturze RAG.

Kalkulacja ROI: ile kosztuje ręczne ofertowanie

Rzadko ktoś liczy ten koszt wprost. Tutaj robimy to za Ciebie.

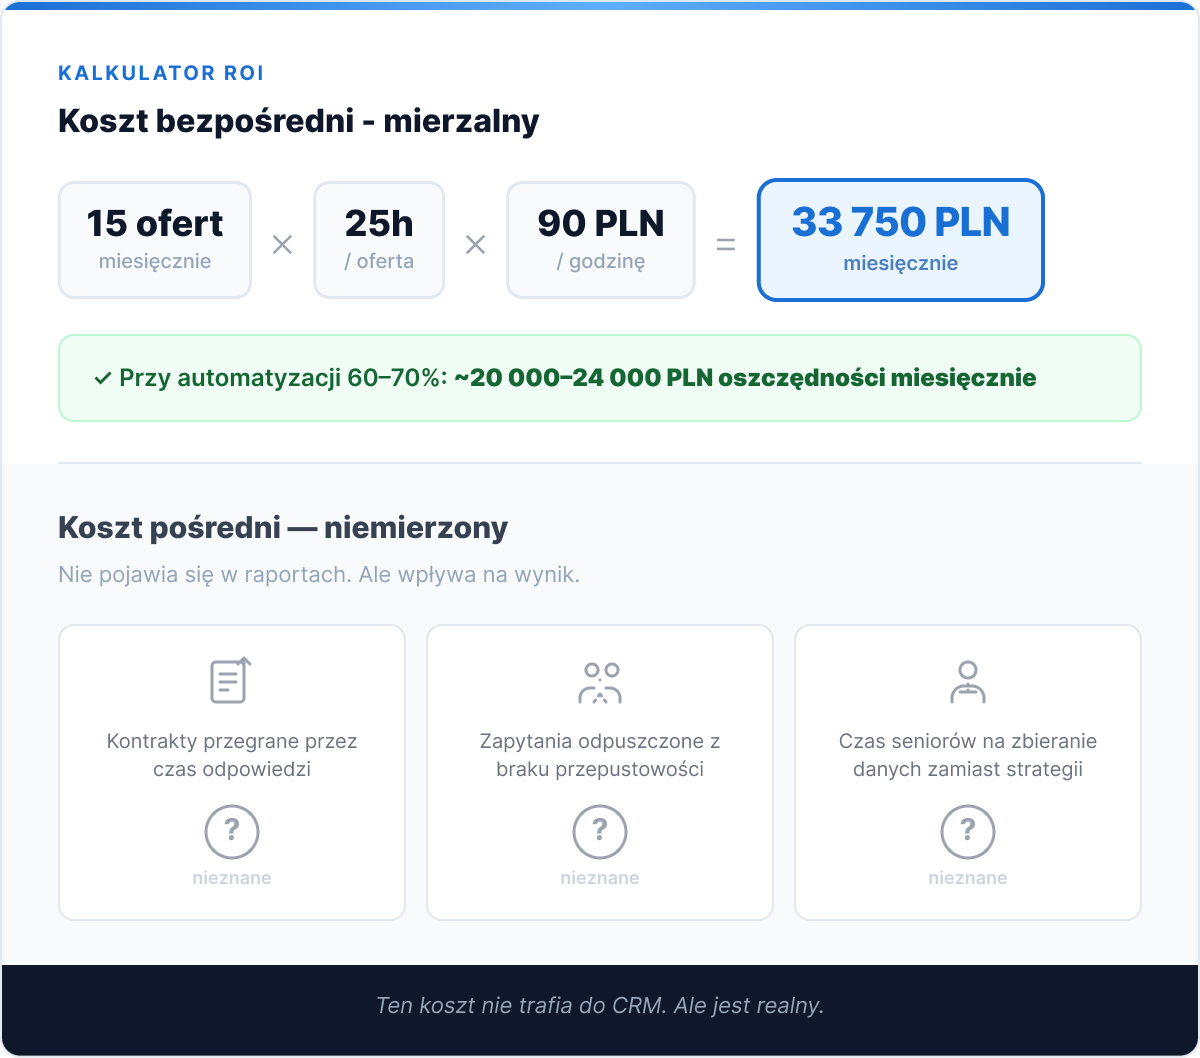
Założenia dla firmy z 5 osobami zaangażowanymi w ofertowanie:

  • Średni czas przygotowania jednej oferty: 25 godzin (Loopio RFP Trends 2025)
  • Liczba zapytań miesięcznie: 15
  • Średni koszt roboczogodziny (handlowiec + wsparcie techniczne): 90 PLN

Koszt manualny miesięcznie: 15 ofert × 25h × 90 PLN = 33 750 PLN

Rocznie: ~405 000 PLN wyłącznie na czas pracy poświęcony ofertowaniu.

To nie jest koszt, który można w całości odzyskać – część czasu na przegląd i personalizację zawsze pozostanie przy człowieku. Ale jeśli automatyzacja przejmie etapy zbierania danych i generowania draftu (szacunkowo 60-70% całego czasu), potencjalna oszczędność wynosi:

~243 000-284 000 PLN rocznie dla firmy z 15 zapytaniami miesięcznie.

Ale koszt bezpośredni to tylko część równania. Wolny proces ofertowania generuje też koszt pośredni: kontrakty, które trafiają do konkurencji, bo odpowiedź przyszła za późno. Ten koszt nie pojawia się w żadnym raporcie. I dlatego nikt go nie mierzy.

Kiedy automatyzacja ofertowania ma sens – a kiedy nie

Uczciwa odpowiedź wymaga wskazania granic.

Automatyzacja przynosi największy ROI gdy:

  • Firma przetwarza minimum 8-10 zapytań ofertowych miesięcznie o powtarzalnej strukturze
  • Dane kosztowe i historyczne projekty są dostępne w systemie – nie wyłącznie w głowach konkretnych osób
  • Oferty bazują w dużej mierze na powtarzalnych komponentach, stawkach lub zakresach prac
  • Integracja z ERP lub cennikiem jest technicznie możliwa

Kiedy warto poczekać lub zacząć od porządkowania danych:

  • Każda oferta jest absolutnie unikalna i wymaga od podstaw opracowanej specyfikacji – zakres automatyzacji będzie minimalny
  • Dane kosztowe i historyczne projekty nie są ustrukturyzowane lub nie ma do nich centralnego dostępu – agent nie ma na czym pracować
  • Wolumen poniżej 5-8 zapytań miesięcznie – próg opłacalności wdrożenia trudno osiągnąć przy niskim wolumenie

Transparentność w tym obszarze to nasz standard. Jeśli na warsztacie discovery okaże się, że dane nie są gotowe – powiemy to wprost i zaproponujemy od czego zacząć.


Case study: firma produkcyjna B2B – z tygodni do jednego dnia

Jeden z naszych partnerów to firma produkcyjna B2B z kilkudziesięcioma zapytaniami ofertowymi miesięcznie, każde wymagające wyceny na podstawie dokumentacji technicznej i aktualnych cen komponentów. Każda oferta angażowała 3-4 osoby i zajmowała od 3 do 10 dni roboczych.

Problem: dane do ofert były rozproszone – cenniki w Excelu, historyczne projekty na SharePoincie z nieustandaryzowaną strukturą, część wiedzy wyłącznie u seniorów technicznych. Przy rosnącym wolumenie zapytań zespół regularnie pracował w nadgodzinach. Część zapytań była odpuszczana, bo nie było czasu na odpowiedź.

Wdrożone rozwiązanie: Agent AI zintegrowany z bazą historycznych projektów, cennikiem i systemem ERP. Przed wdrożeniem: 3 tygodnie porządkowania i indeksowania danych. Następnie 4-tygodniowy PoC na wybranych typach zapytań.

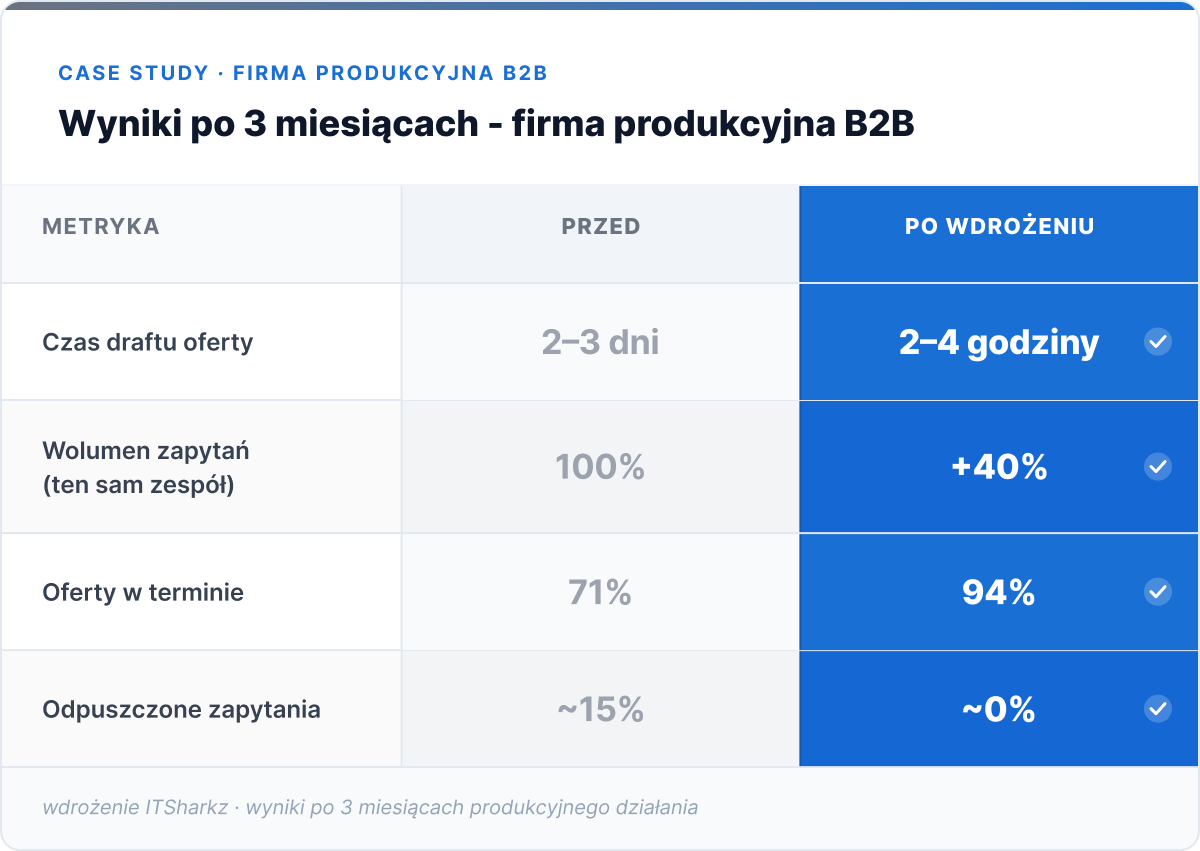
Wyniki po 3 miesiącach:

  • Czas przygotowania draftu: z 2-3 dni do 2-4 godzin
  • Wolumen obsługiwanych zapytań: wzrost o 40% przy tym samym zespole
  • Odsetek ofert złożonych w terminie: z 71% do 94%
  • Odpuszczone zapytania: z ~15% do niemal 0%

Wartość wdrożenia nie leży wyłącznie w oszczędności czasu. Leży w zdolności do uczestnictwa w większej liczbie przetargów bez dodatkowych zatrudnień.

→ Dowiedz się, jak ITSharkz buduje agentów AI dla procesów ofertowania i sprzedaży

Jak zacząć – model wdrożenia w 6 tygodniach

Największy błąd przy wdrożeniu automatyzacji ofertowania: próba automatyzowania całego procesu od razu. Właściwe podejście to wąski PoC na jednym typie zapytań z dobrze przygotowanymi danymi.

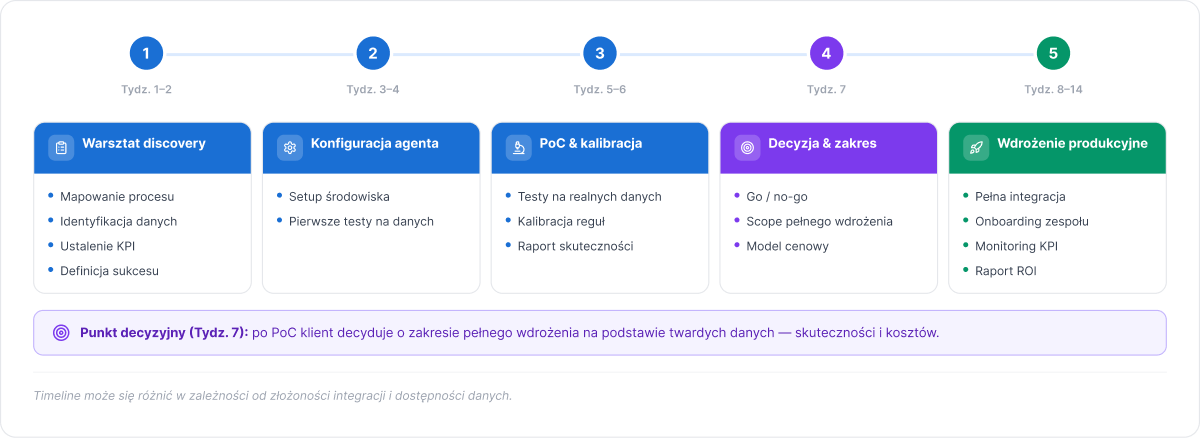
Tydzień 1-2: Discovery i audyt danych Mapowanie aktualnego procesu, identyfikacja typów zapytań, ocena dostępności i jakości danych historycznych. Ten etap często ujawnia, że przed agentem potrzebny jest 2-3-tygodniowy etap porządkowania dokumentacji.

Tydzień 3-4: Konfiguracja i integracje Indeksowanie bazy historycznej, integracja z cennikiem lub ERP, konfiguracja reguł biznesowych (co agent sugeruje, jakie zakresy wymagają walidacji człowieka).

Tydzień 5-6: PoC na wybranym typie zapytań Agent pracuje na realnych zapytaniach w trybie „suggest only”. Na końcu PoC: raport skuteczności jako podstawa decyzji o pełnym wdrożeniu.

Łączny czas od warsztatu do systemu na produkcji: 8-12 tygodni przy jednym typie zapytań i dostępnych danych.

Pełną metodologię wdrożenia – od wyboru przypadku pilotażowego po model cenowy – znajdziesz w przewodniku po wdrożeniu automatyzacji AI w firmie. Jeśli interesuje Cię też temat zarządzania wiedzą wewnętrzną (który często idzie w parze z ofertowaniem), sprawdź artykuł o koszcie szukania informacji w firmie.


Podsumowanie

Automatyzacja procesu ofertowania to jeden z nielicznych obszarów, w których ROI z wdrożenia agenta AI jest szybko i wyraźnie mierzalny – bo czas przygotowania oferty jest policzalny przed i po, a efekt widać w ciągu kilku tygodni.

Trzy rzeczy, które warto zapamiętać:

  • Problem leży w danych, nie w technologii. Agent AI jest tak dobry, jak dobra jest baza historycznych projektów i cenników, do której ma dostęp. Porządkowanie danych przed wdrożeniem nie jest kosztem dodatkowym – to warunek skuteczności.
  • Zakres automatyzacji to 60-70% czasu. Etapy zbierania danych, wyszukiwania historii i generowania draftu. Weryfikacja, personalizacja i decyzja zostają przy człowieku – i to jest właściwe.
  • 68% konkurencji jest już w procesie. Każdy miesiąc opóźnienia to miesiąc, w którym ktoś inny buduje bazę danych i historię ofert, na której agent działa coraz skuteczniej.

Ile zapytań ofertowych miesięcznie obsługuje Twój zespół? Umów warsztat – po jednej rozmowie będziemy wiedzieć, ile z tego można przyspieszyć.

→ Umów bezpłatny warsztat z ITSharkz

Pilot Purgatory: dlaczego większość projektów agentów AI nigdy nie trafia do produkcji – i jak tego uniknąć

Większość projektów agentów AI nie kończy się głośną porażką. Kończy się cicho – demo, które zrobiło wrażenie na zarządzie, pilotaż, który działał przez trzy miesiące, kanał na Slacku, który w końcu ucichł. Nikt oficjalnie nie zamyka projektu. Po prostu przestaje pojawiać się w przeglądach roadmapy.
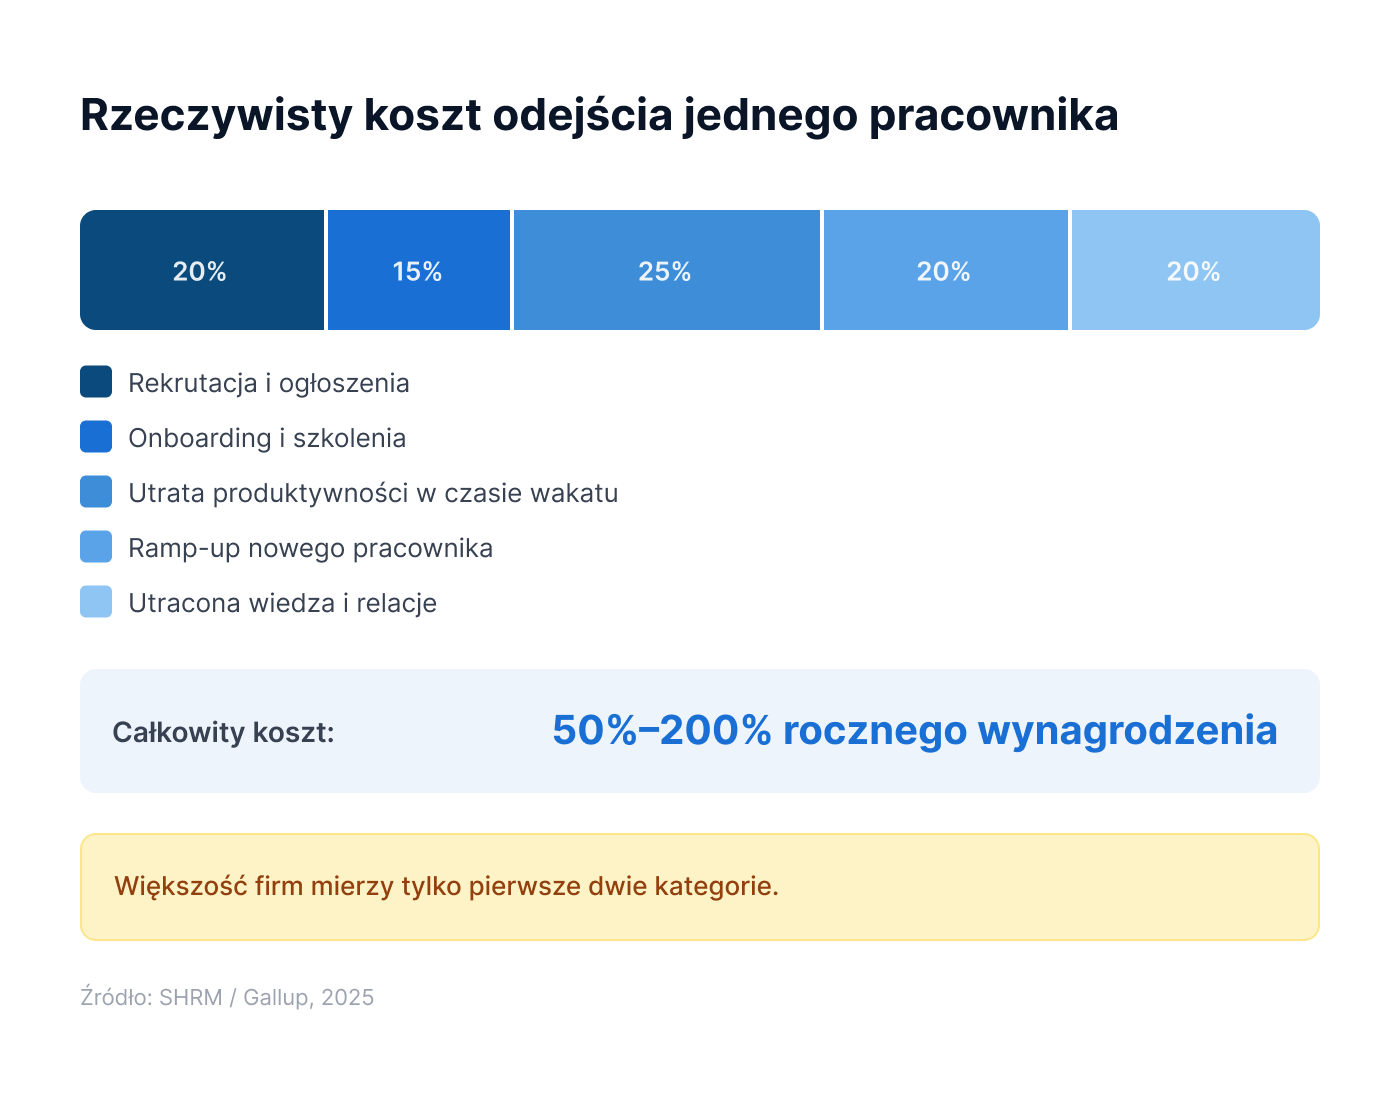
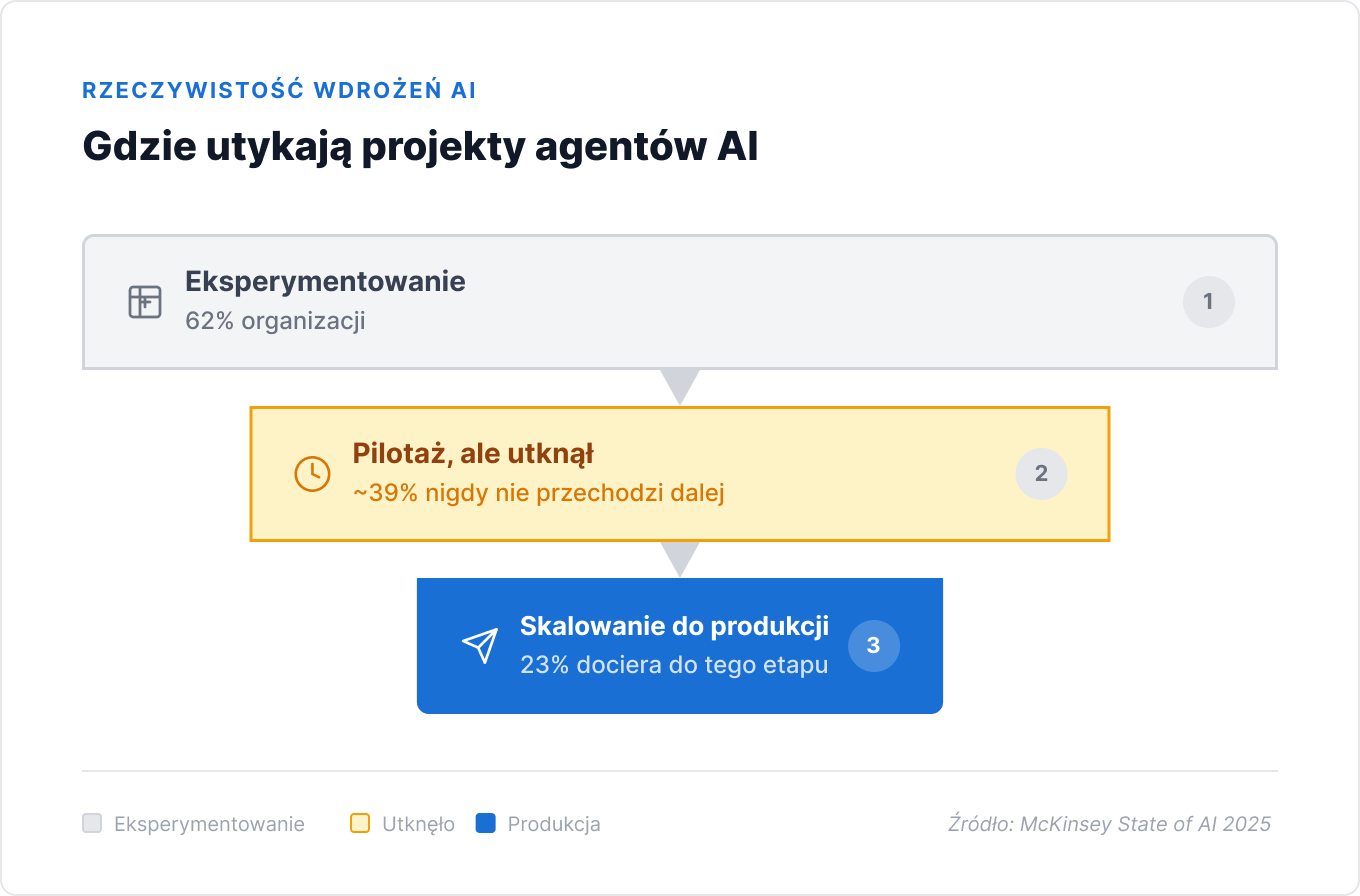
Raport State of AI 2025 firmy McKinsey ujmuje to w liczbach: 62% organizacji testuje agentów AI. Tylko 23% faktycznie wdraża ich na pełną skalę. To właśnie w luce między tymi dwoma liczbami cicho znika większość budżetów na AI.

Prognozy Gartnera są jeszcze bardziej bezpośrednie: ponad 40% projektów agentowej AI zostanie porzuconych do końca 2027 roku – nie dlatego, że technologia nie działa, ale przez rosnące koszty, niejasną wartość biznesową i niewystarczającą kontrolę ryzyka.

To nie jest problem technologiczny. To problem metody. A gdy zobaczy się go kilka razy, staje się przewidywalny.

Schemat: jak naprawdę wygląda utknięty pilotaż

Po odjęciu szczegółów, większość utkniętych projektów agentów AI ma tę samą strukturę.

Zespół – często IT, czasem product manager z entuzjazmem i linią budżetową – buduje proof of concept w oparciu o gotowe API LLM. Działa na demo. Odpowiada na pytania, które zespół pomyślał, żeby zadać. Zarząd jest pod wrażeniem. Czasem powstaje nawet komunikat prasowy.

Potem przychodzi zderzenie z rzeczywistością produkcyjną. Dane, których potrzebuje agent, leżą w sześciu różnych systemach, z czego połowa nieudokumentowana. „Prosty” proces, który miał zostać zautomatyzowany, ma w rzeczywistości czternaście przypadków brzegowych, o których nikt nie wspomniał na spotkaniu startowym. Compliance pyta, kto odpowiada, gdy agent się pomyli, a nikt nie ma jasnej odpowiedzi.

Sześć miesięcy później pilotaż wciąż jest pilotażem. Nie dlatego, że ktoś zdecydował, żeby go zatrzymać – dlatego, że nikt też nie zdecydował, żeby kontynuować.

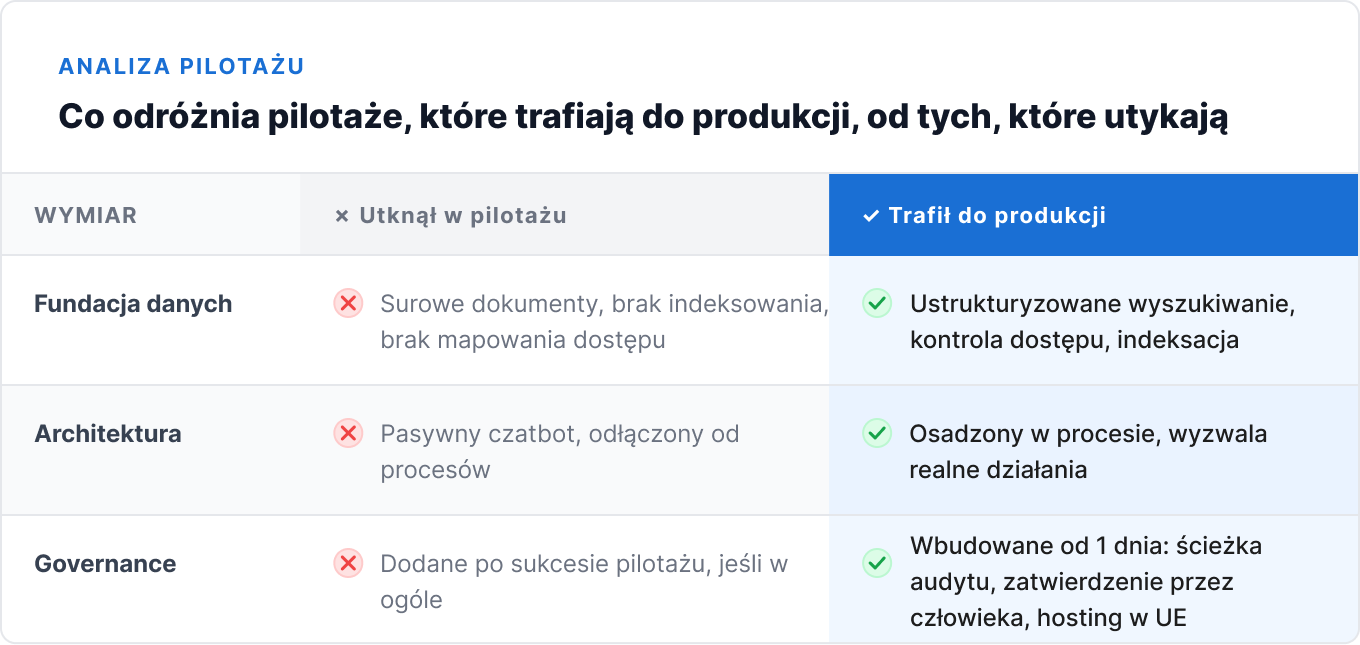
Trzy rzeczy, które odróżniają agentów trafiających do produkcji od tych odłożonych na półkę

W rozmowach discovery, które prowadzimy z firmami oceniającymi partnerów do budowy agentów AI, te same trzy luki pojawiają się raz po raz – niemal niezależnie od branży czy wielkości firmy.

1. Brak uporządkowanej fundacji danych

To zdecydowanie najczęstszy punkt awarii – i zwykle niewidoczny, dopóki pilotaż już nie trwa.

Zespół buduje działający prototyp na czystym, starannie dobranym zbiorze danych – kilka przykładowych dokumentów, uporządkowana baza testowa. Wyniki są świetne. Potem prototyp trafia na realne środowisko: foldery SharePoint z trzema różnymi konwencjami nazewnictwa, system ERP z niespójnymi formatami pól, umowy rozproszone po wątkach mailowych i dyskach współdzielonych, bez żadnych metadanych.

Agent nie jest wadliwy. Fundacja danych pod spodem nigdy nie istniała w formie, z którą agent – czy szczerze mówiąc, nowy pracownik – mógłby wiarygodnie pracować.

Prowadziliśmy wiele rozmów discovery z firmami, które miały już za sobą „pierwszy pilotaż” wykorzystujący ogólne API LLM bezpośrednio na surowych dokumentach – bez warstwy wyszukiwania (retrieval), bez strategii indeksowania, bez mapowania uprawnień dostępu. Pilotaż wyglądał obiecująco w pierwszym tygodniu. Do czwartego tygodnia zespół po cichu przestał ufać jego odpowiedziom.

2. Pasywne czatboty zamiast zintegrowanych workflow

Druga luka jest architektoniczna, nie technologiczna. Wiele pilotaży pierwszej generacji buduje się jako okno czatu doczepione do istniejących systemów – miejsce, gdzie pracownicy mogą zadawać pytania, bez realnego połączenia z procesami, w których faktycznie zapadają decyzje.

Efekt: narzędzie, które ludzie wypróbowują raz, uznają za umiarkowanie ciekawe i zapominają o nim. Odpowiada na pytania. Nie robi nic – nie uruchamia zatwierdzenia, nie aktualizuje rekordu, nie flaguje wyjątku do przeglądu.

Agenci, którzy przetrwają do produkcji, są projektowani odwrotnie: osadzeni bezpośrednio w procesie, z jasno zdefiniowanymi danymi wejściowymi, wyjściowymi i ścieżkami eskalacji. Agent, który weryfikuje fakturę i kieruje ją do zatwierdzenia, gdy coś wygląda podejrzanie, rozwiązuje inny problem niż czatbot, który potrafi odpowiedzieć na pytania o fakturach, jeśli grzecznie się go o to poprosi.

3. Governance jako temat poboczny

Trzecia luka ujawnia się później, ale często jest fatalna, gdy już się pojawi. Pilotaż, który dobrze działał w małej skali, uderza w ścianę w momencie, gdy dział prawny, compliance albo bezpieczeństwo zadają oczywiste pytania: kto zatwierdził temu agentowi dostęp do tych danych? Co się dzieje, gdy popełni błąd? Czy istnieje ścieżka audytu? Czy to zgodne z RODO albo z unijnym AI Act?

Jeśli te pytania padają po raz pierwszy po tym, jak pilotaż pokazał obiecujące wyniki, odpowiedzi zwykle nie są gotowe – a projekt staje w miejscu, podczas gdy organizacja gorączkowo dorabia governance do architektury, która nie była do tego zaprojektowana.

Agenci budowani od razu z zatwierdzeniem human-in-the-loop, pełną identyfikowalnością (traceability) i hostingiem zgodnym z wymogami UE nie napotykają tej ściany. Zostali zaprojektowani, żeby ją przejść od samego początku.

Jak wygląda model agentowego workflow

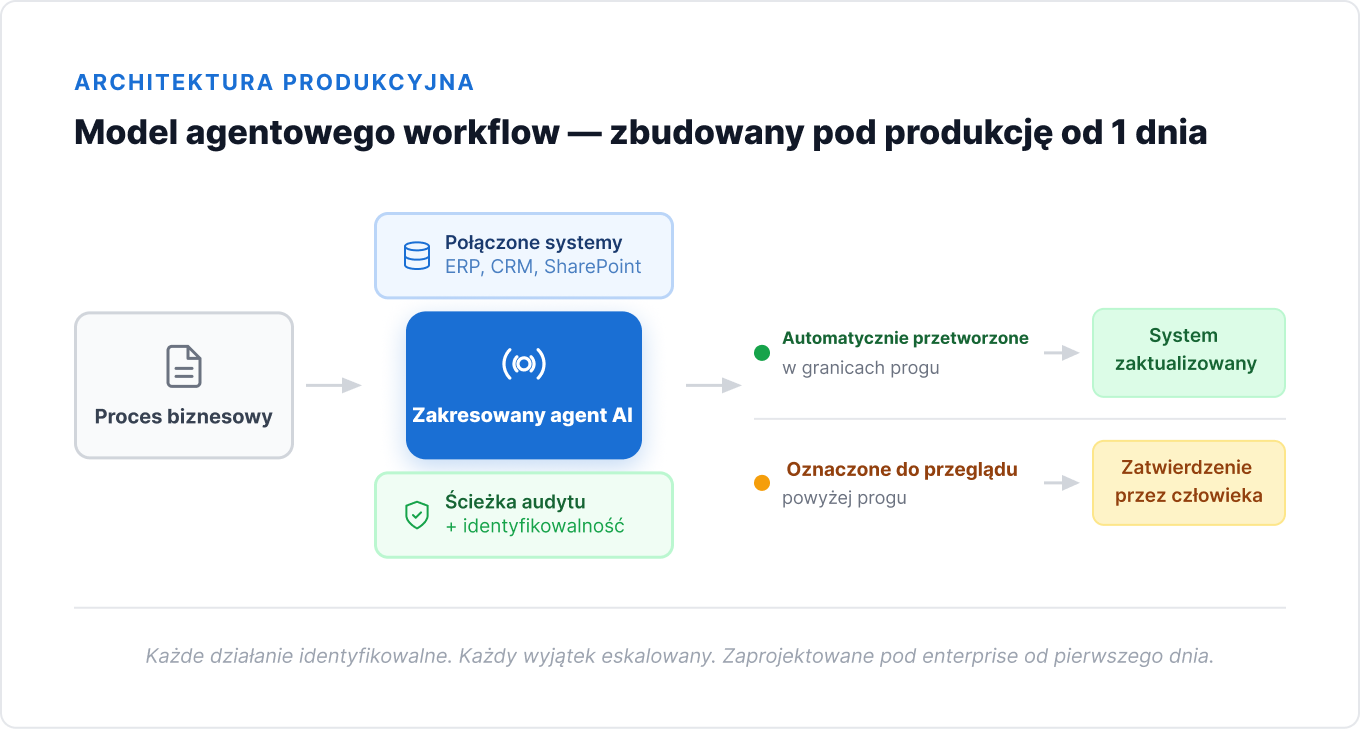
Alternatywą dla czatbota doczepionego do istniejących systemów jest to, co nazywamy modelem agentowego workflow: agent zaprojektowany od początku wokół konkretnego procesu biznesowego, a nie dopasowany później do istniejącego stosu narzędzi.

Różnica widać w trzech konkretnych miejscach:

Agent ma zdefiniowany zakres, nie otwarty mandat. Zamiast „odpowiadaj na dowolne pytanie o naszych dokumentach”, brief brzmi „weryfikuj przychodzące faktury względem zamówień i flaguj rozbieżności powyżej ustalonego progu”. Wąski zakres oznacza, że agenta można ocenić według jasnych kryteriów sukcesu już od pierwszego tygodnia.

Agent łączy się z systemami, nie tylko z oknem czatu. Czyta z ERP, zapisuje z powrotem do niego, wyzwala powiadomienie, gdy coś wymaga przeglądu przez człowieka. Proces nie zmienia się, żeby dopasować się do agenta – to agent jest budowany tak, żeby pasować do już istniejącego procesu.

Decyzje agenta są identyfikowalne od początku. Każde działanie jest logowane. Każda eskalacja zawiera uzasadnienie, które ją wywołało. Gdy compliance pyta „co się tu wydarzyło i dlaczego”, odpowiedź już istnieje – nie trzeba jej odtwarzać po fakcie.

To też dlatego dobrze zakresowany, czterotygodniowy proof of concept zwykle przebija otwarty, sześciomiesięczny pilotaż. Wąski zakres z jasnymi wymaganiami danych i zdefiniowaną metryką sukcesu albo potwierdza słuszność przypadku użycia, albo szybko go odrzuca – zamiast dryfować w pilotażowym czyśćcu przez dwa kwartały, zanim ktoś przyzna, że projekt utknął.

Chcesz zobaczyć, jak ten proces wygląda od początku do końca? Przeczytaj nasz przewodnik po wdrażaniu automatyzacji AI w firmie, łącznie z tym, jak wybrać właściwy przypadek pilotażowy i jak wygląda realistyczny harmonogram 4–8 tygodni.

Powtarzalny wzorzec z naszych rozmów discovery

Jeden wzorzec powtarza się na tyle często, że warto go nazwać: firma średniej wielkości uruchamia pierwszy pilotaż, łącząc ogólne API LLM bezpośrednio z wewnętrznymi dokumentami – bez architektury wyszukiwania, bez warstwy kontroli dostępu, bez zdefiniowanej ścieżki eskalacji. Pilotaż pokazuje, że „AI potrafi odpowiadać na pytania o naszych politykach wewnętrznych”. Nie pokazuje, że odpowiedzi są wiarygodne, możliwe do zaudytowania albo ograniczone do tego, co dany pracownik faktycznie powinien móc zobaczyć.

Sześć miesięcy później pilotaż wciąż jest pilotażem. Firma wydała budżet i zbudowała wewnętrzny sceptycyzm wobec AI jako kategorii – nie dlatego, że pomysł u podstaw był zły, tylko dlatego, że pierwsza próba została zaprojektowana jako demo, nie jako infrastruktura produkcyjna.

Kiedy odbudowujemy takie projekty, punktem startowym rzadko jest „zbuduj mądrzejszy model”. To „zbuduj fundację danych i warstwę governance, której pierwsza wersja nigdy nie miała” – a potem zakresuj na tej podstawie wąski, mierzalny pilotaż. Technologia nigdy nie była wąskim gardłem. Fundacja była.

Jak uniknąć pilotażowego czyśćca: praktyczna checklista

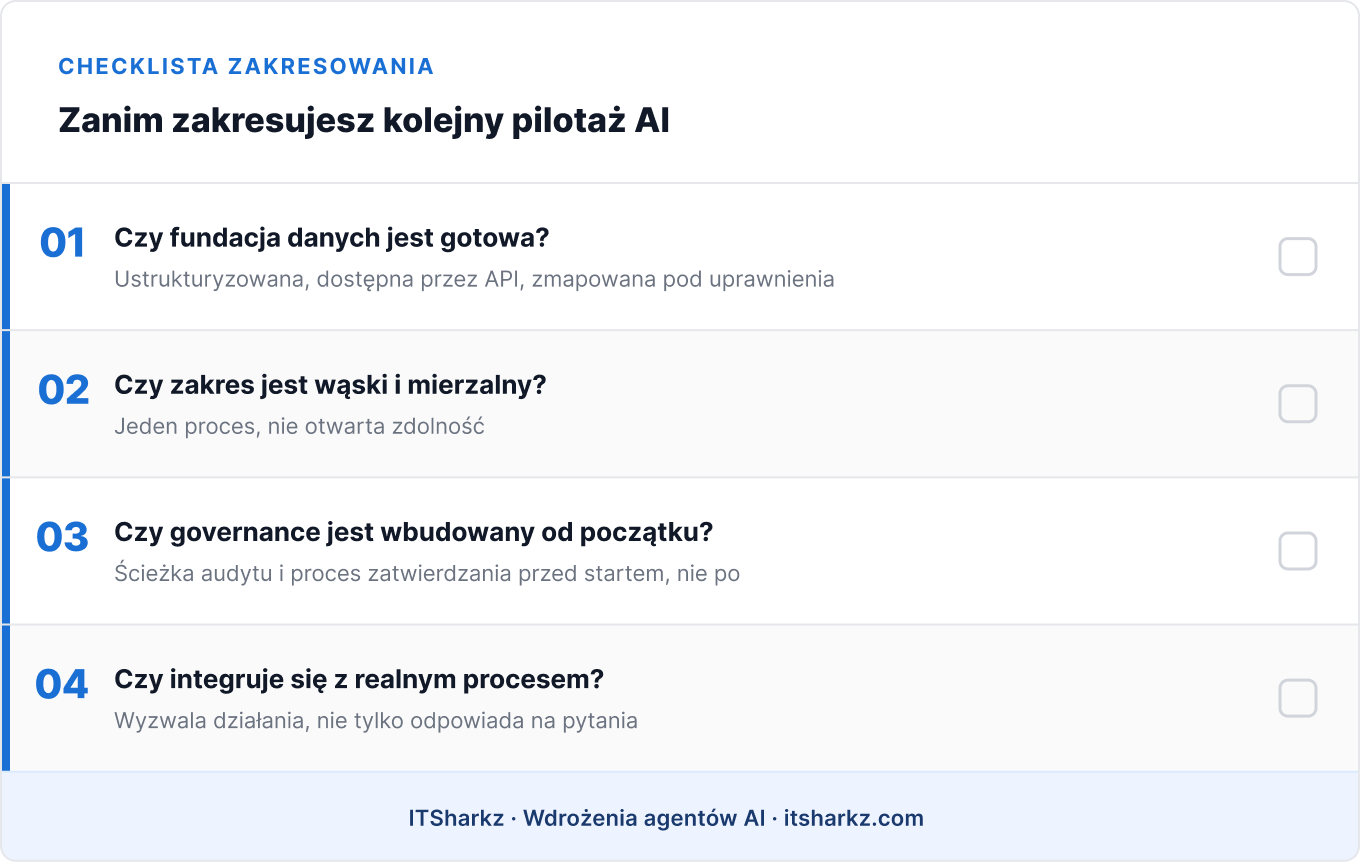
Zanim zakresujesz kolejny pilotaż agenta AI, warto szczerze odpowiedzieć na cztery pytania:

Czy fundacja danych jest faktycznie gotowa? Nie „czy mamy te dane gdzieś” – tylko czy są ustrukturyzowane, dostępne przez API i zmapowane na uprawnienia dostępu, które powinny regulować, kto (albo co) może je zobaczyć?

Czy pilotaż jest zakresowany na jeden, mierzalny proces – czy na otwartą zdolność? „Zautomatyzuj weryfikację faktur dla naszych 10 głównych dostawców” to pilotaż. „Spraw, żeby nasza baza wiedzy była przeszukiwalna przez AI” to projekt badawczy przebrany za pilotaż.

Czy governance jest wbudowany od początku, czy zaplanowany na później? Jeśli compliance, dział prawny i bezpieczeństwo nie przejrzały architektury przed startem pilotażu, zrobią to po – przy dużo wyższym koszcie w czasie i zaufaniu.

Czy agent integruje się z realnym procesem, czy tylko odpowiada na pytania? Jeśli metryką sukcesu jest „ludziom wydaje się to ciekawe”, to inny projekt niż „to skraca czas obsługi o X%”. Tylko jeden z nich przetrwa przegląd budżetowy.

Jeśli nie potrafisz jasno odpowiedzieć na wszystkie cztery pytania, to nie powód, żeby porzucić projekt – to właściwy punkt startowy. Dobrze zakresowany, czterotygodniowy PoC jest zaprojektowany dokładnie po to, żeby odpowiedzieć na te pytania, zanim zaangażuje się dalszy budżet.


→ Zobacz, jak ITSharkz projektuje i buduje agentów AI gotowych do produkcji – od fundacji danych po wdrożenie.

Podsumowanie

Luka między 62% testującymi a 23% wdrażającymi na skalę to nie luka technologiczna. To luka fundamentu – w danych, w architekturze i w governance.

Trzy rzeczy do zapamiętania:

  • Większość pilotaży nie zawodzi dlatego, że model jest słaby. Utykają, bo fundacja danych pod spodem nigdy nie została zbudowana z myślą o produkcyjnym użyciu.
  • Czatbot, który odpowiada na pytania, to inny produkt niż agent osadzony w procesie. Tylko ten drugi przetrwa kontakt z przeglądem budżetowym.
  • Governance wbudowany od pierwszego dnia jest szybszy, nie wolniejszy. Dorabianie compliance do architektury, która nie była pod to zaprojektowana – to realnie zabija harmonogramy.

Jeśli zastanawiasz się, od czego zacząć, nasz przewodnik po wdrażaniu automatyzacji AI pokazuje krok po kroku, jak wybrać właściwy przypadek pilotażowy i jak wygląda realistyczny harmonogram produkcyjny.


Porozmawiaj z ITSharkz o zakresowaniu pilotażu zaprojektowanego tak, żeby trafić do produkcji – nie tylko zrobić wrażenie na demo. → Umów spotkanie z Kacprem

Twoi pracownicy tracą nawet 2 godziny dziennie na szukaniu informacji. Ile to kosztuje Twoją firmę?

Wyobraź sobie, że jeden z Twoich pracowników – prawnik, HR Business Partner, Project Manager – ma do zweryfikowania umowę. Wie, że gdzieś w SharePoincie jest wzorzec. Że ktoś rok temu negocjował podobną klauzulę. Że procedura dla tego zakresu prac siedzi w folderze, którego nazwy nie pamięta.

Spędza 25 minut, żeby to wszystko zebrać. Codziennie. Przy każdej podobnej sprawie.

Pomnóż to przez liczbę pracowników i liczbę dni roboczych. Wychodzi liczba, której nikt w firmie nigdy nie policzył – bo nie pojawia się w żadnym raporcie.

Jeden z pięciu pracowników zamiast pracować, szuka

McKinsey Global Institute oszacował, że pracownicy wiedzy mogą poświęcać niemal 20% tygodnia pracy na szukanie informacji wewnętrznych lub docieranie do osób, które je posiadają. To historyczny benchmark z 2012 roku, ale dobrze pokazuje skalę problemu.

W badaniu Glean i Harris Poll z 2022 roku pracujący Amerykanie deklarowali średnio co najmniej 2 godziny dziennie poświęcane na szukanie dokumentów, informacji lub właściwych osób. 43% respondentów rozważyłoby odejście z firmy, gdyby nie miało efektywnego sposobu dostępu do wiedzy potrzebnej do pracy.

Problem nie jest nowy. Nowa jest skala, w jakiej można go dziś rozwiązać.

Ile to właściwie kosztuje – kalkulacja, której nikt nie robi

Liczby są proste. Rzadko ktoś je liczy wprost.

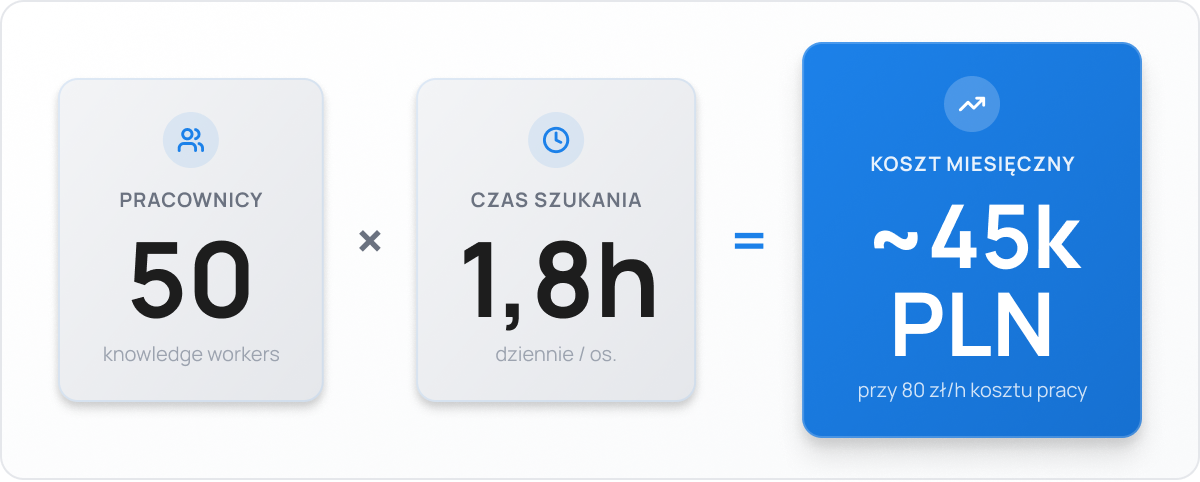
Przy 50 pracownikach, koszcie godziny pracy 80 PLN i 1,8h szukania dziennie:

50 osób × 1,8h × 80 PLN × 22 dni robocze = 158 400 PLN miesięcznie

To koszt czasu pracy poświęconego na szukanie informacji, która już gdzieś jest. Bez żadnego błędu, żadnej nieobecności, żadnego kryzysu. Po prostu dlatego, że wiedza jest rozproszona.

158 400 PLN to całkowity koszt czasu objętego takim założeniem — nie kwota, którą można automatycznie odzyskać. Część wyszukiwania jest niezbędnym elementem pracy i nie zniknie po wdrożeniu nowego narzędzia.

Jeśli przyjmiemy, że lepszy dostęp do wiedzy ograniczy ten czas o 30–50%, potencjalnie odzyskana wartość wyniesie około 47 500–79 200 PLN miesięcznie. Dla firmy zatrudniającej 200 pracowników skala rośnie czterokrotnie.

Jak to wygląda w praktyce – dział po dziale

W ciągu ostatnich miesięcy rozmawialiśmy z kilkoma firmami o tym, gdzie konkretnie wiedza „ginie”. Wzorzec powtarza się niezależnie od branży.

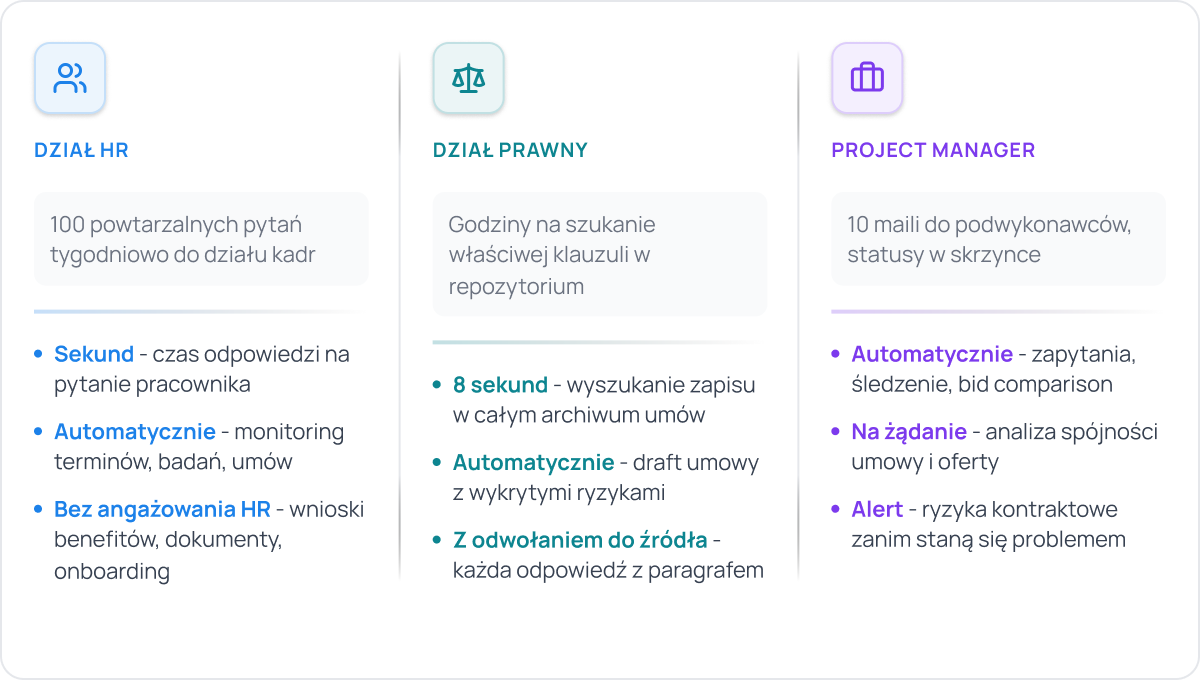
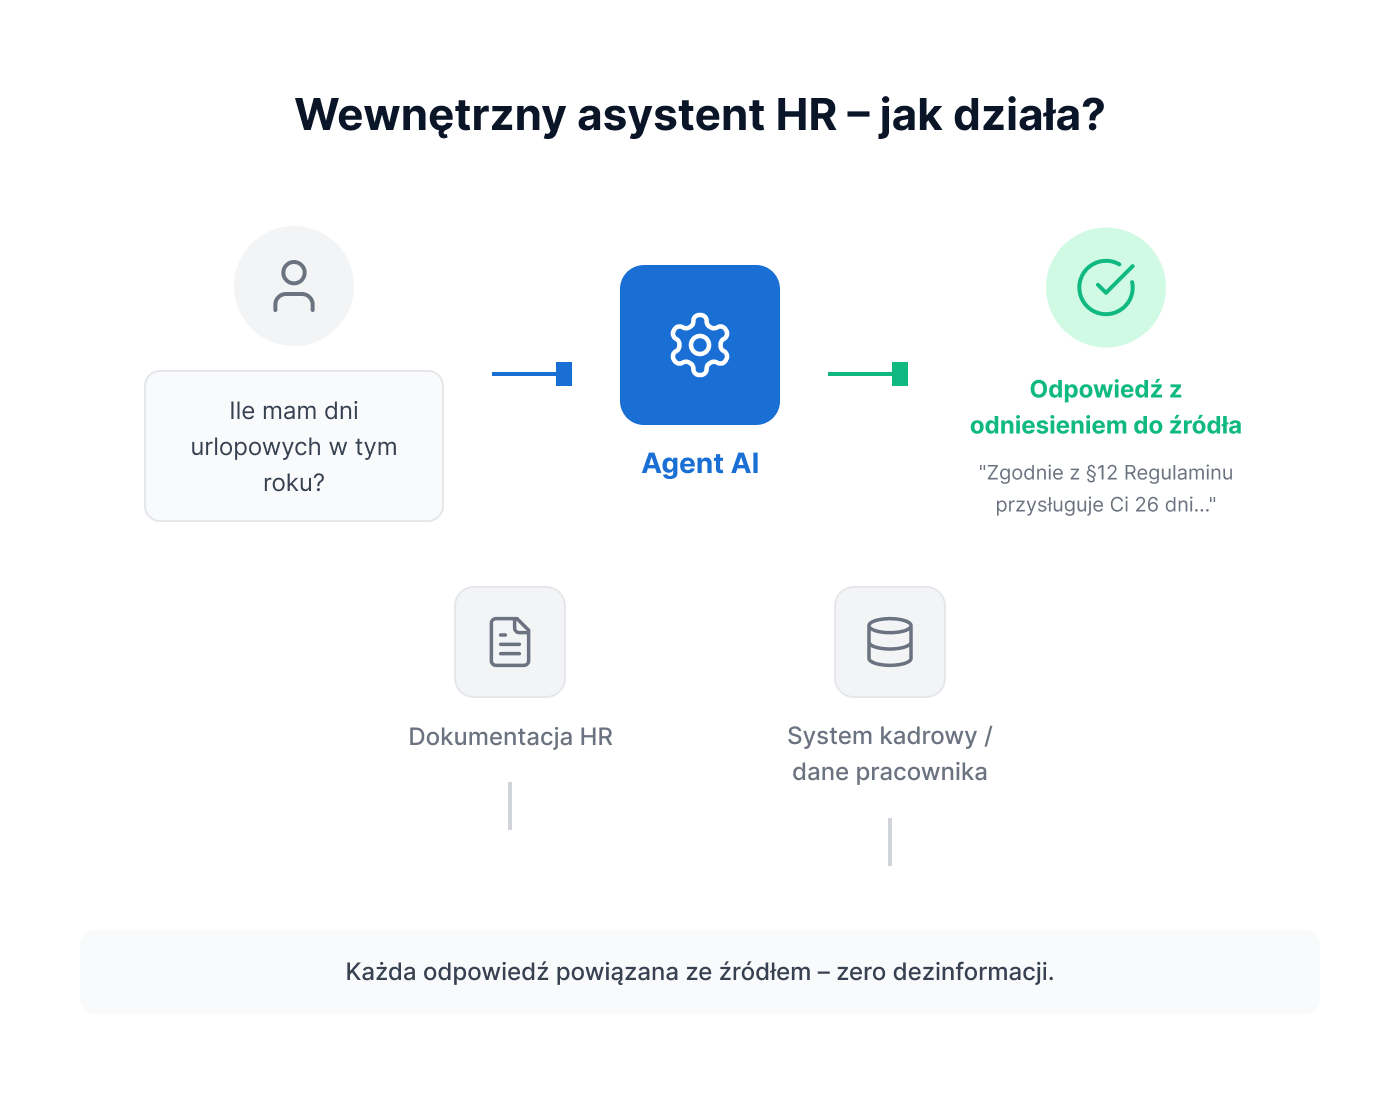
Dział HR obsługuje setki powtarzalnych pytań tygodniowo. „Ile mam urlopu?” „Jaka jest procedura zgłoszenia L4?” „Kiedy wypłata?” Każde pytanie trafia do człowieka, który musi oderwać się od swojego zadania, żeby odpowiedzieć.

Dział prawny spędza godziny na szukaniu właściwej klauzuli w archiwum umów. Prawnik wie, że podobna umowa była negocjowana rok temu. Nie pamięta, w którym folderze. Szuka 40 minut.

Project Manager śledzi statusy podwykonawców w skrzynce mailowej zamiast w jednym miejscu. Musi ręcznie agregować informacje z 10 wątków, żeby odpowiedzieć na jedno pytanie zarządu.

Wspólny mianownik: wiedza jest. Tylko dotarcie do niej kosztuje za dużo czasu.

Jak agent AI skrócił czas wyszukiwania z 20 minut do kilku sekund

To nie jest temat tylko dla finansów czy operacji.

Wdrożyliśmy agenta AI dla sieci prywatnych placówek medycznych – kilka tysięcy pracowników, wiele lokalizacji, procedury, przepisy kadrowe, umowy, regulaminy wewnętrzne – wszystko rozproszone po różnych folderach i systemach.

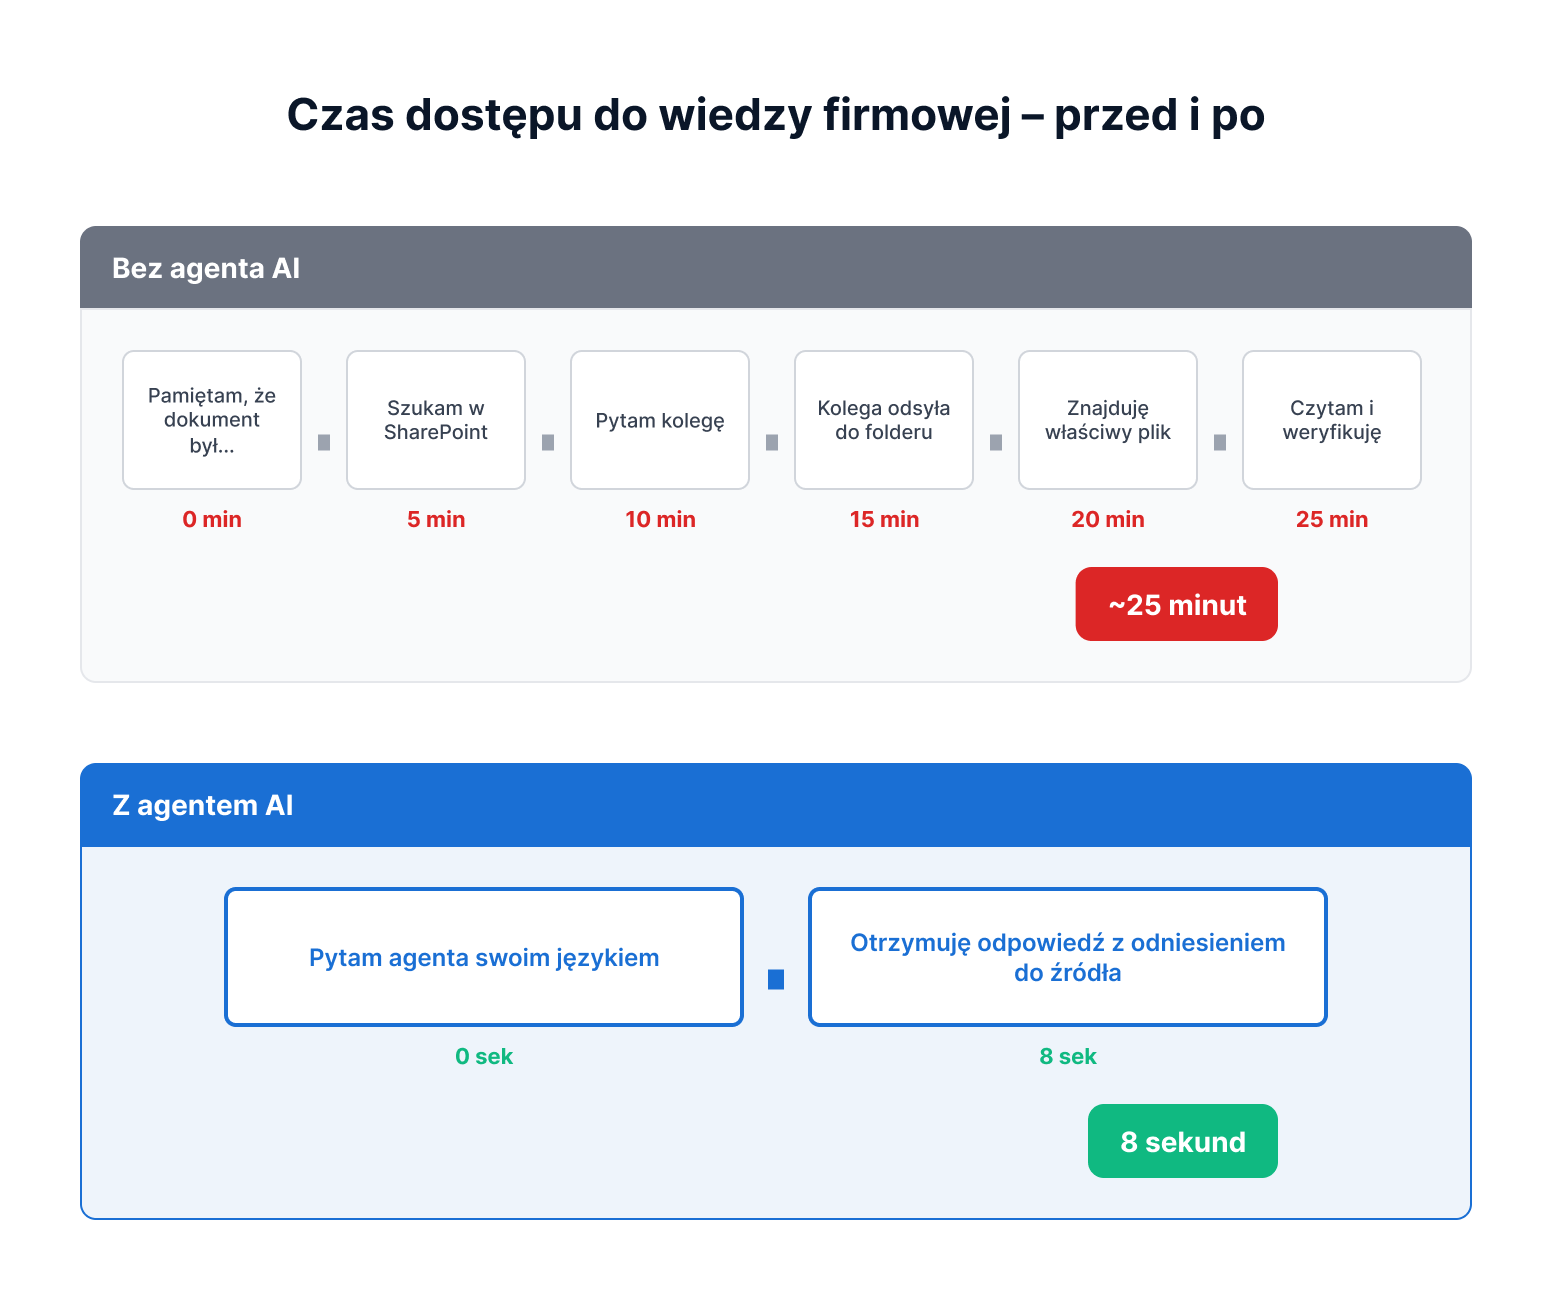
Pracownik mógł wcześniej spędzić 20 minut szukając odpowiedzi na pytanie o zasady nadgodzin albo wymogi konkretnej procedury. Każde „proste pytanie” wymagało albo przeszukania dokumentów, albo zaangażowania kogoś z HR lub działu prawnego.

Zbudowaliśmy dedykowanego agenta AI opartego na architekturze RAG – system, który zna tożsamość rozmówcy (integracja z Active Directory), jego uprawnienia i dane kadrowe. Pracownik pyta swoim językiem. Agent odpowiada w kilka sekund i wskazuje źródło – konkretny dokument, artykuł regulaminu, paragraf umowy.

Efekt:

  • Czas wyszukiwania informacji: z 20 minut do kilku sekund
  • Jeden punkt dostępu do całej wiedzy firmowej zamiast dziesiątek rozproszonych folderów
  • Dział HR przestał obsługiwać setki powtarzalnych zapytań tygodniowo

Asystent jest skonfigurowany tak, aby odpowiadać na podstawie zatwierdzonych źródeł organizacji i respektować uprawnienia użytkownika. Hosting i przetwarzanie danych w EOG ograniczają złożoność transferową, ale zgodność z RODO zależy również od podstawy prawnej, retencji danych, logowania, umów z dostawcami i sposobu przetwarzania informacji przez model.

Chcesz zobaczyć, jak taka architektura działa od strony technicznej? Szczegółowe wyjaśnienie znajdziesz w artykule o RAG i danych firmowych.

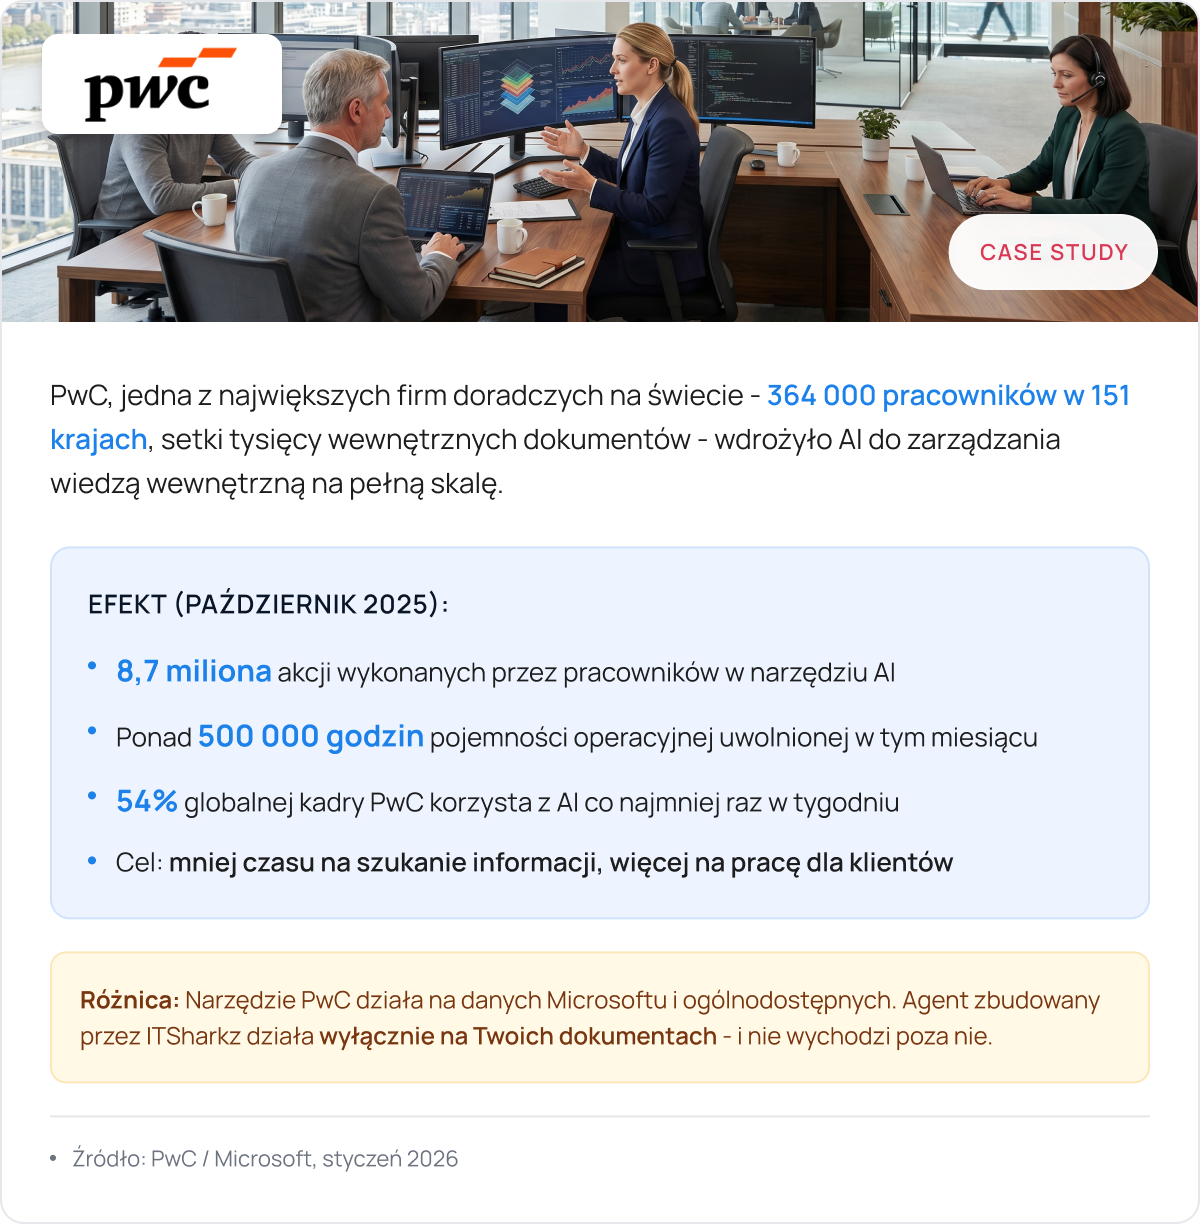
Jak robi to PwC – benchmark na skalę enterprise

PWC case study AI

Różnica jest istotna: narzędzie PwC działa na danych Microsoftu i ogólnodostępnych. Agent zbudowany przez ITSharkz działa wyłącznie na Twoich dokumentach – i nie wychodzi poza nie. To kluczowe dla firm, które nie mogą pozwolić sobie na to, żeby dane firmowe były przetwarzane przez zewnętrzne modele bez kontroli.

Dlaczego warto działać teraz, a nie za rok

Firmy, które wcześniej wdrażają wewnętrznych asystentów wiedzy, zyskują czas na uporządkowanie źródeł, poprawę metadanych, zbudowanie zestawu testowego i dostosowanie odpowiedzi do rzeczywistych potrzeb pracowników. Przewaga nie wynika z tego, że agent automatycznie „uczy się” z każdym pytaniem, lecz z systematycznego doskonalenia całego rozwiązania.

Wiedza operacyjna często pozostaje w głowach konkretnych osób. Asystent AI może ułatwić dostęp do wiedzy, która została już udokumentowana, ale nie wydobędzie samodzielnie informacji, których nigdy nie zapisano. Dlatego wdrożenie warto połączyć z porządkowaniem procedur, wywiadami z ekspertami i dokumentowaniem decyzji.

Każdy dział ma swój „tajny folder”, wiadomość sprzed roku lub procedurę znaną tylko jednej osobie. Asystent AI nie zastępuje ekspertów. Sprawia, że zatwierdzona wiedza staje się łatwiejsza do znalezienia i wykorzystania przez całą organizację.

Jeśli zastanawiasz się, od czego zacząć wdrożenie – przeczytaj przewodnik po wdrożeniu automatyzacji AI w firmie. A jeśli interesuje Cię, jak agent AI radzi sobie z danymi pracowniczymi w sposób zgodny z RODO – sprawdź artykuł o automatyzacji HR z AI.

czas dostępu do wiedzy przed i po

Podsumowanie

Koszt utraconego czasu na szukanie informacji to jedna z największych ukrytych strat operacyjnych w firmach 50-500 pracowników. Nie pojawia się w żadnym raporcie. Nikt jej nie mierzy. I właśnie dlatego nikt jej nie rozwiązuje.

Trzy rzeczy, które warto zapamiętać:

  • 1,8 godziny dziennie na osobę to nie statystyka – to koszt. Przy 50 pracownikach i 80 PLN/h to ponad 45 000 PLN miesięcznie w samym czasie, wyłącznie na szukanie.
  • Agent AI oparty na RAG rozwiązuje ten problem architektonicznie – jeden punkt dostępu do całej wiedzy firmowej, odpowiedzi w sekundy, każda z odwołaniem do źródłowego dokumentu.
  • Hosting w UE, RODO by design, dostęp na uprawnienia – agent widzi tylko to, co dany pracownik powinien widzieć. Dane nie opuszczają organizacji.

Ile godzin miesięcznie Twój zespół traci na szukaniu? Po jednej rozmowie – oboje będziemy to wiedzieć.

→ Umów bezpłatny warsztat z ITSharkz

Systemy wieloagentowe – kiedy jeden agent AI nie wystarczy

Pojedynczy agent AI działa świetnie, gdy zadanie jest wyraźnie zdefiniowane, dane są dostępne w jednym miejscu i sekwencja działań jest przewidywalna. Weryfikacja faktur. Odpowiedzi na pytania pracowników. Routing zgłoszeń serwisowych.

Ale co, gdy proces wymaga kilku niezależnych obszarów odpowiedzialności, różnych specjalizacji lub odrębnych poziomów dostępu? Samo przeszukiwanie wielu źródeł czy równoległe wykonywanie zadań nie zawsze wymaga MAS – często wystarczy jeden agent z narzędziami albo dobrze zaprojektowany workflow.

System wieloagentowy ma sens wtedy, gdy rozdzielenie ról realnie poprawia jakość, skalowalność lub kontrolę nad procesem.

Gartner zanotował wzrost zapytań o systemy wieloagentowe (MAS) o 1 445% między Q1 2024 a Q2 2025 – co czyni je jednym z najszybciej rosnących tematów w enterprise AI. Jednocześnie badanie IDC zlecone przez AWS pokazuje, że tylko 3% organizacji skaluje agentic AI między działami, a mniej niż 7% ma co najmniej jeden przypadek użycia w pełnej produkcji.

Ten artykuł wypełnia lukę między teorią a praktyką. Jeśli dopiero zaczynasz temat agentów AI, zacznij od artykułu wprowadzającego. Jeśli rozumiesz już pojedynczych agentów i chcesz wiedzieć, kiedy i jak wyjść poza jeden – jesteś we właściwym miejscu.

Granice pojedynczego agenta AI

Pojedynczy agent działa w ramach jednego głównego cyklu decyzyjnego, ale może korzystać z wielu narzędzi, pamięci zewnętrznej i równoległych wywołań. Wąskim gardłem staje się wtedy, gdy musi jednocześnie zarządzać wieloma niezależnymi rolami, kontekstami i poziomami uprawnień.

Trzy sygnały, że Twój proces przekracza granice jednego agenta:

Zbyt wiele kroków, zbyt wiele danych. Pojedynczy agent traci kontekst przy długich, wieloetapowych procesach. Okno kontekstu modelu ma swój limit – przy 20-krokowym procesie z wieloma źródłami danych pierwsze kroki zaczynają „wypadać” z pamięci agenta.

Zadania, które powinny wykonywać się równolegle. Jeden agent lub workflow również może uruchamiać zadania równolegle. MAS jest uzasadniony wtedy, gdy każde z tych zadań wymaga własnego kontekstu, instrukcji, narzędzi lub uprawnień.

Różne zadania wymagają różnych specjalizacji. Agent ogólny jest przeciętny we wszystkim. Agent wyspecjalizowany w analizie prawnej tekstu będzie znacznie lepszy od ogólnego – ale nie nadaje się do generowania raportów finansowych. Złożone procesy wymagają ekspertów, nie generalistów.

Czym jest system wieloagentowy i jak działa orkiestracja

System wieloagentowy (MAS, Multi-Agent System) to architektura, w której wiele wyspecjalizowanych agentów AI współpracuje, żeby zrealizować złożone zadanie – każdy robi to, co robi najlepiej, a wyniki ich pracy są koordynowane przez warstwę orkiestracji.

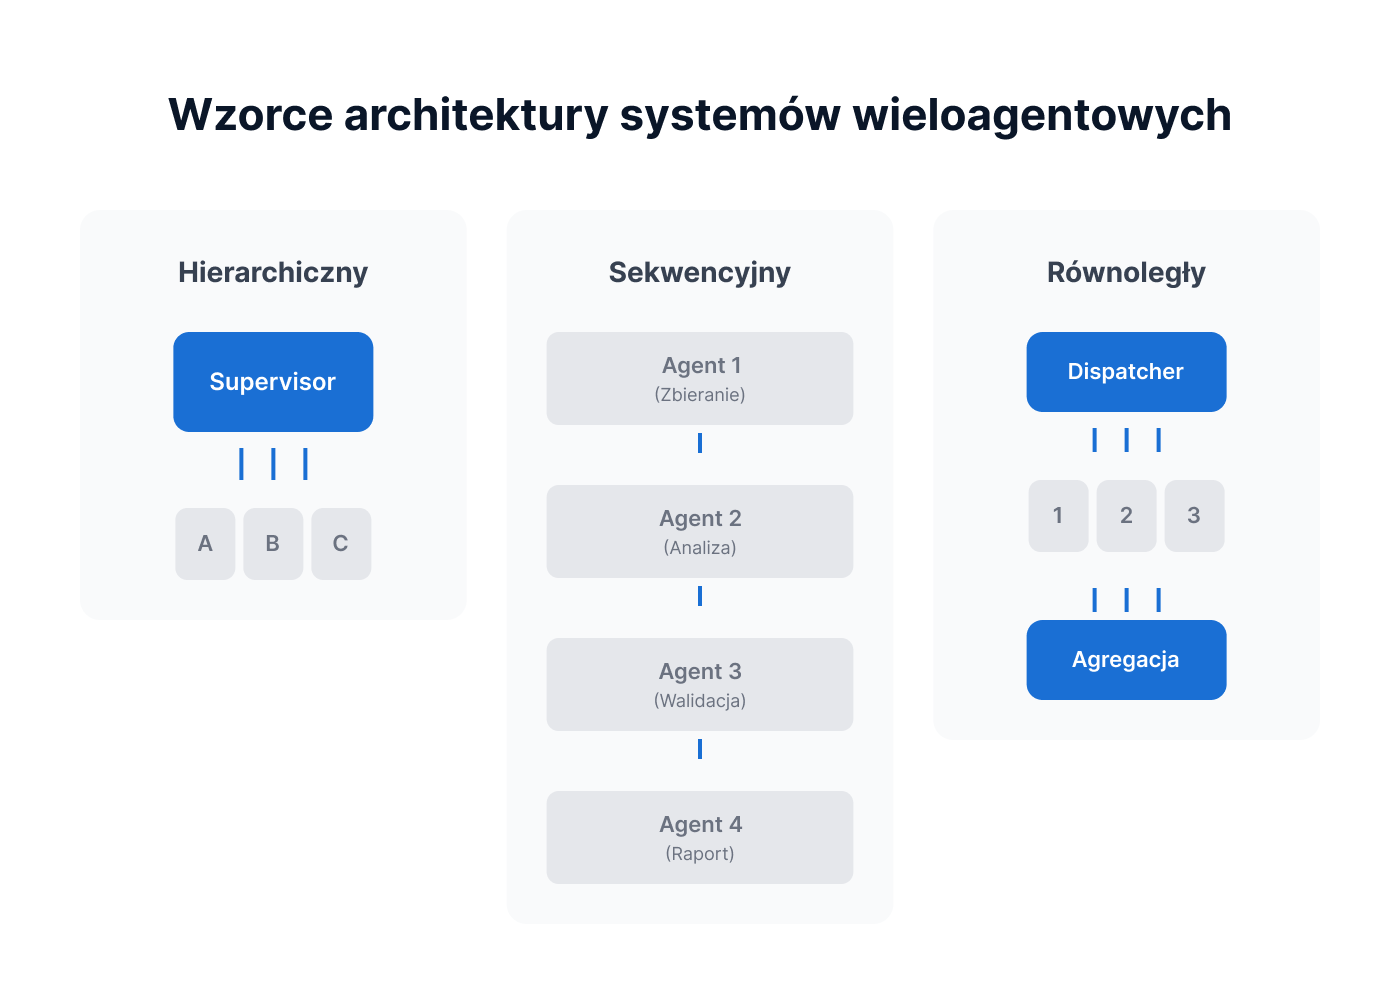
Trzy podstawowe wzorce architektury:

Hierarchiczny (supervisor + executors)
Agent-supervisor dzieli zadanie na podzadania i deleguje je do wyspecjalizowanych agentów-wykonawców. Zbiera wyniki, integruje je i podejmuje decyzje o kolejnych krokach. To najczęściej stosowany wzorzec w wdrożeniach enterprise – przewidywalny, audytowalny i łatwy do zarządzania.

Sekwencyjny (pipeline)
Agenci działają w określonej kolejności – wynik jednego staje się wejściem kolejnego. Dobry dla procesów z naturalnym przepływem etapów: zbieranie danych → analiza → walidacja → raport. Prosto się debuguje, bo wiadomo dokładnie, który agent zawiódł.

Równoległy (parallel execution)
Agenci działają jednocześnie na niezależnych podproblemach. Wyniki są agregowane po zakończeniu wszystkich zadań. Optymalne dla zadań, które można podzielić na niezależne części – np. analiza rynku w 5 krajach jednocześnie.

W praktyce dojrzałe systemy łączą wszystkie trzy wzorce: supervisor koordynuje, część zadań idzie sekwencyjnie, część równolegle.

Wzorce architektury MAS - multiagentowych systemów

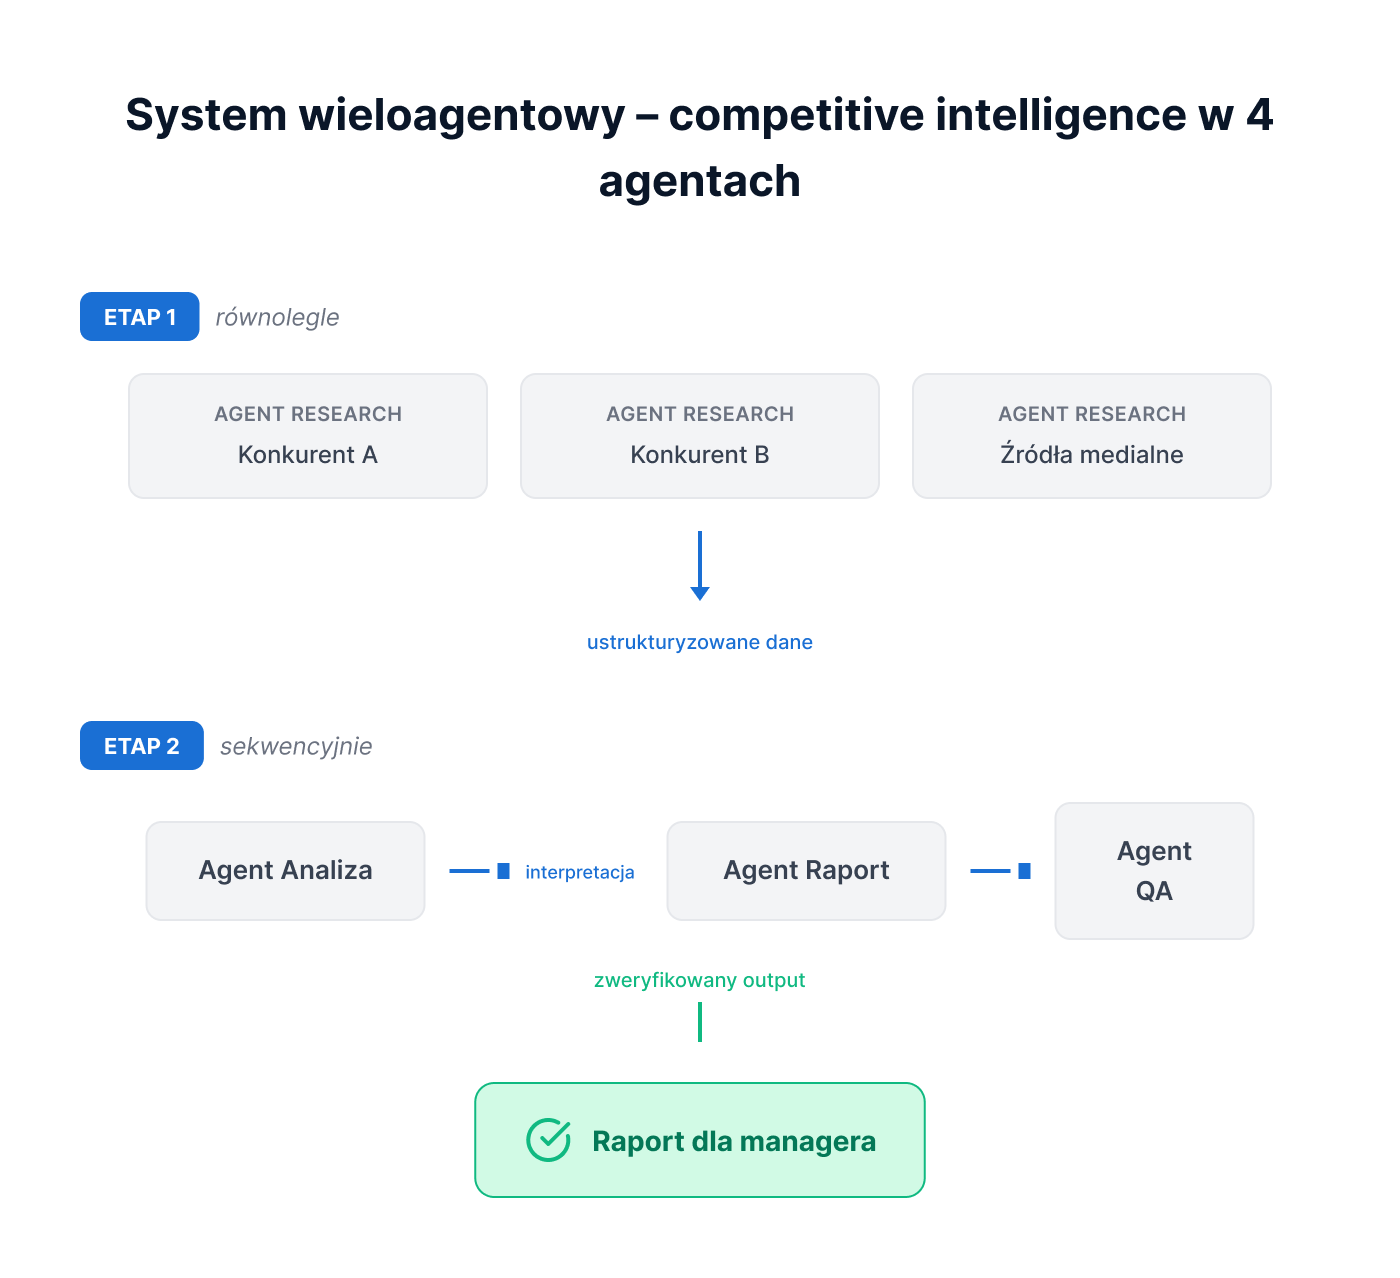
Przykład: research + analiza + raport + QA jako 4 współpracujące agenty

Żeby nie mówić abstrakcyjnie – pokażemy jak wygląda system wieloagentowy w praktyce na przykładzie procesu, który dobrze ilustruje jego wartość.

Zadanie: firma chce co tydzień automatyczny raport competitive intelligence – co robią konkurenci, jakie mają nowe produkty, co piszą media branżowe, jakie są nastroje w komentarzach.

Jeden agent: możliwy, ale powolny i podatny na błędy. Przy 10 konkurentach i 5 źródłach każdy iteracja to długi, sekwencyjny proces. Kontekst się rozrasta, jakość odpowiedzi spada.

System wieloagentowy:

  • Agent Research (×N): osobny agent dla każdego konkurenta lub kategorii źródeł. Działają równolegle. Każdy przeszukuje przypisane mu źródła i zwraca ustrukturyzowany wynik.
  • Agent Analiza: przyjmuje wyniki wszystkich agentów Research, identyfikuje wzorce, trendy i anomalie. Generuje interpretację, nie tylko listę faktów.
  • Agent Raport: formatuje wyniki zgodnie z szablonem firmy, generuje executive summary, nadaje priorytety informacjom według zdefiniowanych kryteriów.
  • Agent QA: weryfikuje, czy raport jest kompletny, czy nie zawiera wewnętrznych sprzeczności, czy źródła są poprawnie cytowane. Flaguje sekcje wymagające ludzkiej weryfikacji.

Wynik: raport, który jeden agent produkowałby kilka godzin, system wieloagentowy generuje w ułamku czasu – z wyraźnym podziałem odpowiedzialności i śledzeniem każdego kroku.

System wieloagentowy - competitive intelligence w 4 agentach

Jak rozdzielić odpowiedzialności między agentami bez chaosu

To jest miejsce, w którym większość projektów się wywraca. Nie na poziomie technologii – na poziomie projektowania.

Trzy zasady, które stosujemy przy każdym wdrożeniu MAS:

1. Jeden agent, jedno zadanie, jeden wyraźny output
Agent powinien mieć dokładnie zdefiniowany zakres wejścia (co przyjmuje) i wyjścia (co produkuje). Jeśli jeden agent „robi research i trochę analizuje”, a drugi „analizuje i częściowo raportuje” – masz przepis na niezdefiniowane zachowanie i trudny debugging. Granice muszą być ostre.

2. Kontrakty między agentami
Każde przejście między agentami powinno mieć zdefiniowany format danych – nie „agent A przekazuje wyniki agentowi B”, ale „agent A produkuje JSON z polami X, Y, Z, które agent B oczekuje jako input”. To jest odpowiednik TypeScript interfaces w kodzie – bez tego każda zmiana w jednym agencie może złamać kolejny.

3. Idempotentność i możliwość restartu
Jeśli agent w środku pipeline’u zawiedzie – co się dzieje? W dobrze zaprojektowanym MAS każdy agent może być bezpiecznie uruchomiony ponownie bez degradacji całego systemu. Wymaga to logowania stanu po każdym kroku i projektowania agentów jako bezstanowych tam, gdzie to możliwe.

Zarządzanie i nadzór: kto zatwierdza decyzje w systemie MAS

To pytanie jest coraz ważniejsze – i dobrze to widać w ewolucji podejścia dużych organizacji. Jak wskazuje raport Deloitte o orkiestracji agentów AI, firmy wdrażające MAS w 2025 roku koncentrowały się na stosunkowo prostych orkiestracjach pod nadzorem człowieka. Bardziej złożone, autonomiczne systemy spanning wielu domen to nadal terytorium liderów rynku.

Kluczowy dylemat: im więcej autonomii – tym szybciej, ale im więcej ryzyka. Im więcej human-in-the-loop – tym bezpieczniej, ale wolniej.

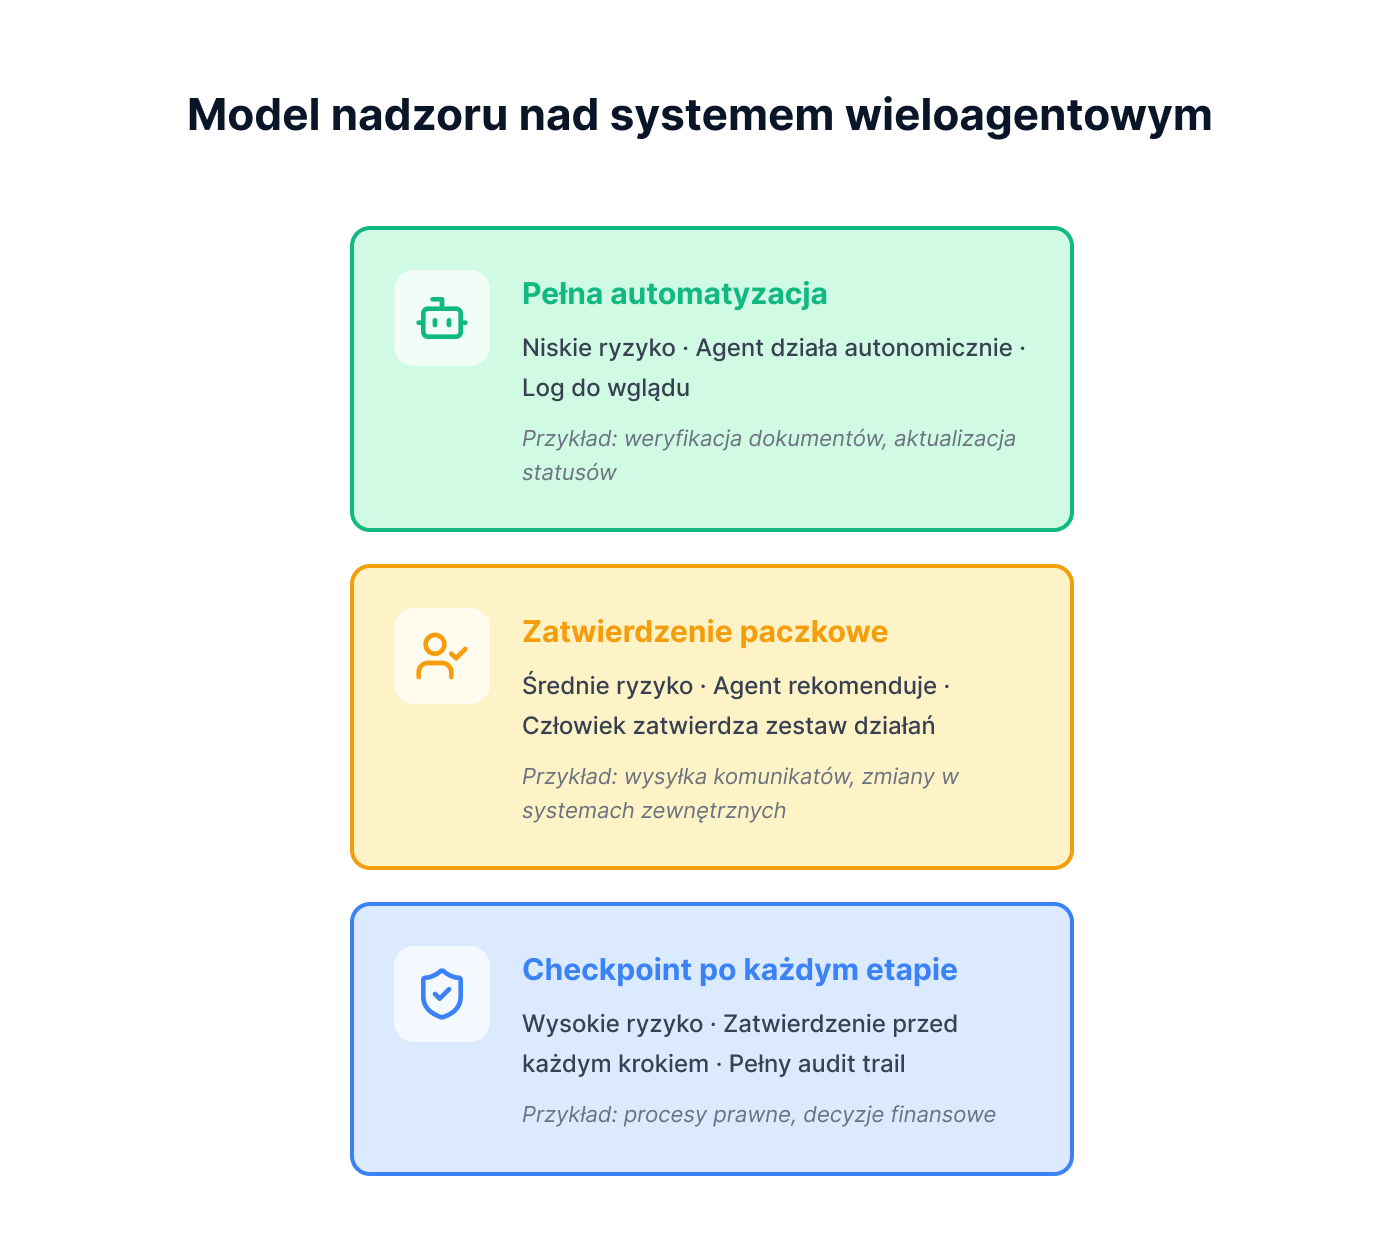
W praktyce enterprise stosujemy trzypoziomowy model nadzoru:

Poziom 1 – Pełna automatyzacja (bez zatwierdzenia)
Zadania niskiego ryzyka z jasno zdefiniowanymi wynikami i łatwą weryfikacją. Weryfikacja formalna dokumentu, aktualizacja statusu w systemie, generowanie standardowego raportu. Agent działa, loguje, człowiek może przejrzeć po fakcie.

Poziom 2 – Zatwierdzenie przed wykonaniem akcji
Zadania o średnim ryzyku lub wpływie na systemy zewnętrzne. Agent przygotowuje rekomendację i listę działań do wykonania – człowiek zatwierdza paczkę działań jednym kliknięciem lub ją modyfikuje. Utrzymuje nadzór bez konieczności ręcznego wykonywania każdego kroku.

Poziom 3 – Checkpoint po każdym etapie
Zadania wysokiego ryzyka, dane wrażliwe, procesy prawne lub finansowe o dużym wpływie. Każdy etap wymaga zatwierdzenia przed przejściem do kolejnego. Wolniej, ale pełna kontrola i pełny audit trail.

Wybór poziomu nie jest stały – może zmieniać się w czasie, gdy system zbiera historię działań i buduje zaufanie. Poziom nadzoru powinien zależeć od ryzyka, odwracalności działania i skutków potencjalnego błędu. Rutynowe, dobrze przetestowane zadania można stopniowo automatyzować, ale procesy wysokiego ryzyka mogą pozostać pod obowiązkowym nadzorem człowieka.

Model nadzoru nad systemem wieloagentowym

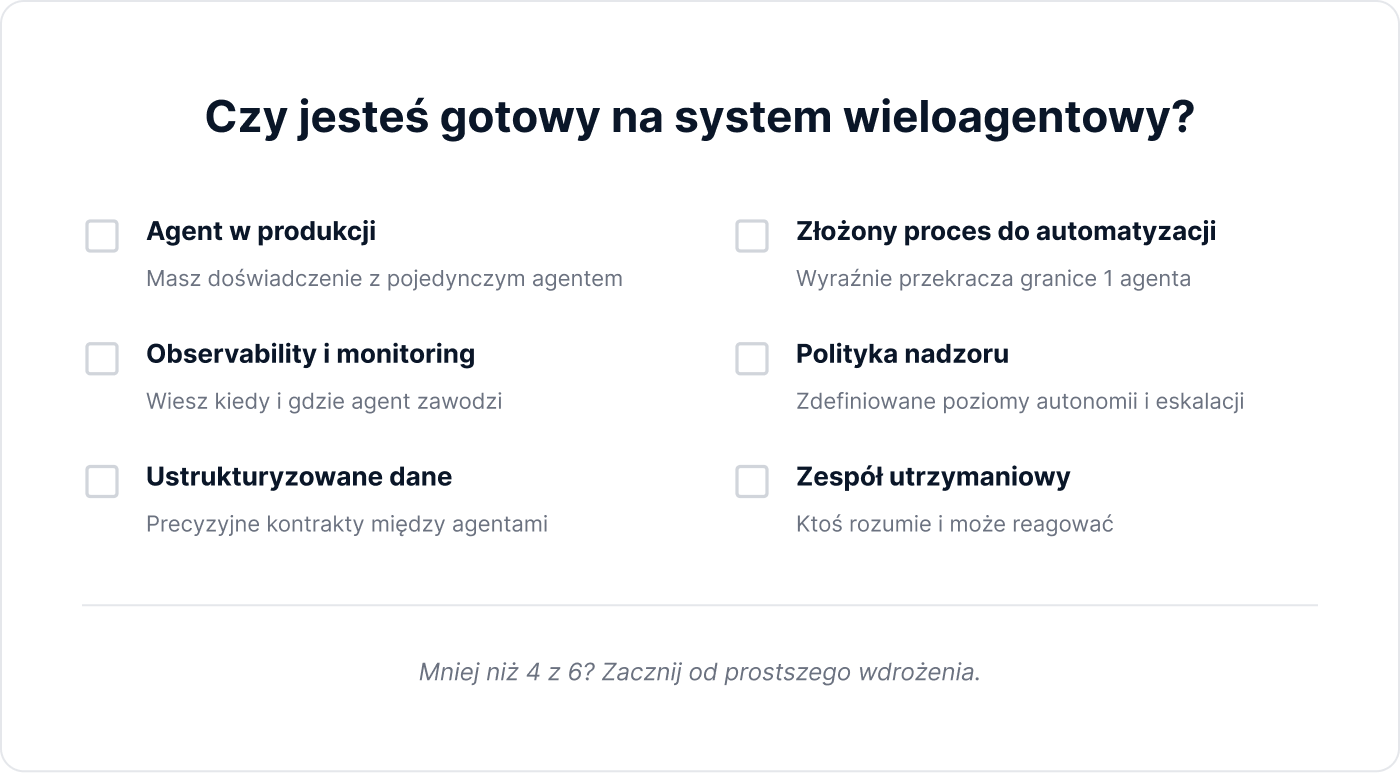
Czy MAS jest dla Twojej firmy – matryca gotowości

Systemy wieloagentowe nie są właściwym następnym krokiem dla każdej firmy. Są właściwym następnym krokiem dla firm, które spełniają konkretne warunki.

Zanim zaczniesz projektować MAS, odpowiedz uczciwie na sześć pytań:

1. Czy masz już działającego pojedynczego agenta w produkcji?
MAS buduje się na fundamencie doświadczenia z pojedynczymi agentami. Jeśli nie wdrożyłeś jeszcze żadnego agenta w środowisku produkcyjnym – MAS to zbyt duży krok. Zacznij od artykułu o tym, jak wdrożyć automatyzację AI w firmie.

2. Czy masz proces, który wyraźnie przekracza granice jednego agenta?
Konkretny proces, nie abstrakcyjna wizja. Zbyt długi pipeline, zadania wymagające równoległego wykonania, potrzeba różnych specjalizacji w jednym przepływie.

3. Czy masz infrastrukturę do monitorowania i obserwowania agentów?
MAS bez observability to czarna skrzynka. Musisz wiedzieć, który agent zawodzi, jak długo każdy krok trwa i gdzie gubi się kontekst. Bez tego debugging staje się koszmarnym projektem.

4. Czy masz zdefiniowaną politykę nadzoru?
Kto zatwierdza które decyzje? Na jakim poziomie autonomii zaczynasz? Jak wygląda eskalacja przy awarii? Bez odpowiedzi na te pytania MAS jest ryzykiem, nie rozwiązaniem.

5. Czy Twoje dane są wystarczająco ustrukturyzowane?
MAS wymaga precyzyjnych kontraktów między agentami. Jeśli dane między etapami są nieustrukturyzowane lub niespójne – każde przejście między agentami będzie potencjalnym punktem awarii.

6. Czy masz zespół zdolny do utrzymania systemu?
MAS to żywy system – agenty wymagają aktualizacji, kontrakty między nimi ewoluują, nowe przypadki brzegowe pojawiają się w produkcji. Potrzebujesz kogoś, kto to rozumie i może reagować.

Czy jesteś gotowy na system wieloagentowy?

Podsumowanie

Systemy wieloagentowe to nie przyszłość – to teraźniejszość dla firm, które przeszły przez etap pojedynczych agentów i szukają skali. Ale są też najczęściej nadużywanym terminem w enterprise AI – wiele zespołów planuje MAS, zanim jeszcze wdrożyło pierwszego agenta w produkcji.

Trzy rzeczy, które warto zapamiętać:

  • MAS ma sens, gdy jeden agent wyraźnie nie wystarczy – zbyt długi pipeline, konieczność równoległości lub różne specjalizacje w jednym procesie. Nie wdrażaj MAS, jeśli pojedynczy agent rozwiązuje problem wystarczająco dobrze.
  • Projektowanie granic między agentami jest ważniejsze niż wybór frameworka. Jeden agent, jedno zadanie, jeden wyraźny output z precyzyjnym kontraktem danych. Bez tego każda zmiana w jednym agencie niszczy cały system.
  • Zacznij od wysokiego nadzoru, zmniejszaj stopniowo. MAS z poziomem 3 (checkpoint po każdym etapie) na starcie jest bezpieczniejszy i buduje zaufanie. Autonomię zwiększa się gdy system ma historię działań.

Jeśli jesteś na etapie budowania fundamentów pod automatyzację AI – wróć do artykułu o tym, jak wdrożyć automatyzację AI w firmie. Jeśli interesuje Cię architektura danych, na której opierają się agenty w MAS – przeczytaj artykuł o RAG i danych firmowych.


Zbuduj system agentów AI z ITSharkz – od architektury po wdrożenie produkcyjne.
→ itsharkz.com/pl/ai-agents/

RAG w praktyce – jak agenci AI „uczą się” z dokumentów Twojej firmy

Jest jedno pytanie, które pojawia się w niemal każdej rozmowie z CTO lub architektem IT, który rozważa wdrożenie agenta AI: „Ale skąd ten agent będzie wiedział, co jest w naszych systemach?”

To właściwe pytanie i przez długi czas nie było na nie dobrej odpowiedzi.

Standardowy model językowy (LLM) wie dużo o świecie – do daty swojego trenowania. Nie wie nic o Twojej firmie. Nie zna Twoich procedur, umów, regulaminów, historii projektów ani aktualnych danych z ERP. Jeśli zapytasz go o dane firmy bez dostarczenia odpowiedniego kontekstu, może odmówić odpowiedzi albo wygenerować treść, która brzmi wiarygodnie, ale nie ma oparcia w źródłach. W środowisku produkcyjnym takie nieuzasadnione lub niezgodne z faktami odpowiedzi są jednym z rodzajów halucynacji.

RAG ogranicza ten problem architektonicznie, dostarczając modelowi odpowiedni kontekst w momencie zapytania, zamiast próbować zapisać aktualną wiedzę firmy w parametrach modelu.

Jak wskazuje analiza ewolucji RAG z połowy 2025 roku, architektura ta przeszła drogę od doraźnego narzędzia redukującego halucynacje do fundamentalnego wzorca budowania wiarygodnych systemów AI w środowiskach enterprise.

Ten artykuł wyjaśnia jak – w języku architekta systemu, nie akademickiego paperu. Jeśli jesteś na etapie oceny, czy agent AI ma w ogóle sens dla Twojej firmy, zacznij od artykułu wprowadzającego o agentach AI. Jeśli już wiesz, że chcesz go wdrożyć, i interesuje Cię, jak podłączyć go do własnych danych – jesteś we właściwym miejscu.

Dlaczego standardowy LLM nie zna Twoich danych firmowych

LLM (Large Language Model) to model wytrenowany na ogromnym zbiorze tekstu z internetu, książek i baz danych – do określonej daty. Jego wiedza jest statyczna. Nie aktualizuje się automatycznie i nie ma dostępu do Twoich systemów.

Trzy konsekwencje, które mają znaczenie w środowisku enterprise:

Wiedza ma datę ważności. Model nie zna Twojego aktualnego regulaminu, najnowszej wersji umowy z kontrahentem ani decyzji zarządu z zeszłego miesiąca. Odpowiedź na pytanie „jaka jest aktualna polityka urlopowa?” będzie albo błędna, albo niemożliwa do udzielenia.

Model nie zna Twoich danych wewnętrznych. Dokumenty, których nie ma w publicznym internecie – wewnętrzne procedury, bazy klientów, historia projektów, dane z ERP – są dla standardowego LLM niewidoczne. Nie ma znaczenia, jak dokładnie zadasz pytanie.

Halucynacje są strukturalnym problemem, nie błędem implementacji. Gdy model nie ma wystarczających informacji, może odmówić odpowiedzi, ale może również wygenerować odpowiedź brzmiącą wiarygodnie, mimo że jest ona nieprawidłowa lub nie ma oparcia w dostępnych źródłach.

Fine-tuning może poprawić sposób wykonywania określonego zadania, format odpowiedzi, zachowanie modelu lub rozumienie specjalistycznego języka. Nie jest jednak optymalnym mechanizmem utrzymywania często zmieniającej się wiedzy firmowej. Jeżeli konkretne fakty zostaną zapisane w parametrach modelu, ich aktualizacja może wymagać kolejnego cyklu treningu i walidacji. RAG dostarcza aktualny kontekst w momencie zapytania bez modyfikowania wag modelu.

RAG rozwiązuje te problemy inaczej.

Jak działa RAG – bez zbędnych uproszczeń

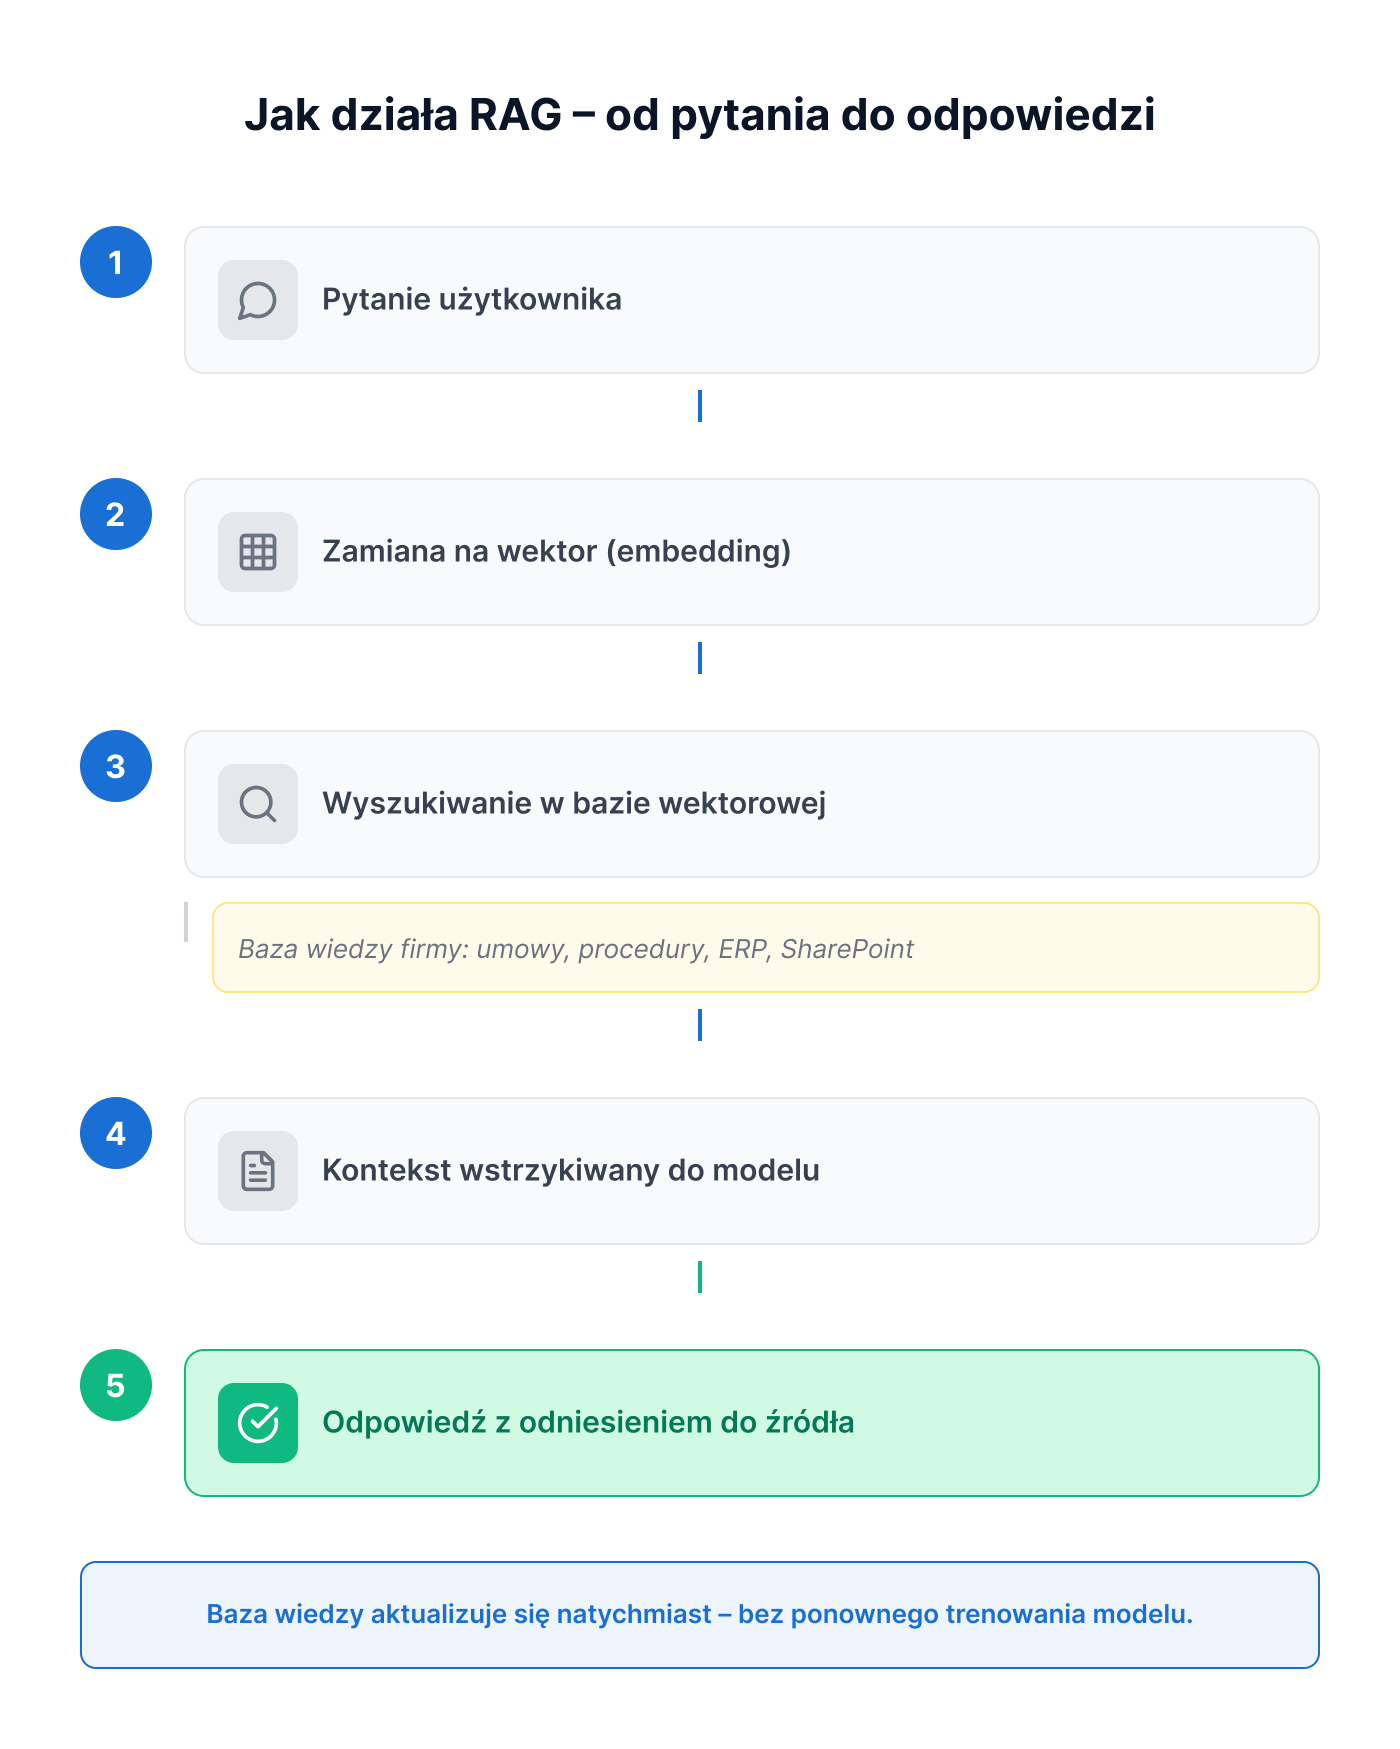
RAG (Retrieval-Augmented Generation) to wzorzec architektoniczny, w którym model językowy otrzymuje dodatkowy kontekst pobrany z zewnętrznego źródła wiedzy. W popularnym wariancie system wyszukuje odpowiednie fragmenty dokumentów za pomocą wyszukiwania wektorowego, tekstowego lub hybrydowego, a następnie przekazuje je modelowi przed wygenerowaniem odpowiedzi.

Sekwencja działania wygląda następująco:

1. Pytanie użytkownika trafia do systemu
„Jakie są warunki gwarancji dla kontraktu z kontrahentem X?”

2. System przygotowuje zapytanie do warstwy wyszukiwania
W przypadku wyszukiwania wektorowego pytanie jest przetwarzane przez model embeddingowy na reprezentację numeryczną. System może również wykorzystać wyszukiwanie tekstowe, filtry metadanych lub podejście hybrydowe łączące kilka metod.

3. Wyszukiwanie odpowiedniego kontekstu
System przeszukuje indeks dokumentów, wykorzystując podobieństwo semantyczne, dopasowanie tekstowe, metadane lub kombinację tych metod. Wyniki mogą zostać dodatkowo uporządkowane przez re-ranking.

4. Kontekst trafia do modelu
Znalezione fragmenty są wstrzykiwane do promptu jako kontekst: „Na podstawie poniższych dokumentów odpowiedz na pytanie…”

5. Model generuje odpowiedź zakorzenioną w danych
Odpowiedź jest generowana z wykorzystaniem pobranych fragmentów dokumentów, ale nadal zależy również od parametrów modelu, instrukcji systemowych i sposobu przygotowania kontekstu. System może wskazać dokument i sekcję źródłową, jednak zgodność odpowiedzi z cytowanym fragmentem powinna być dodatkowo weryfikowana.

Kluczowa różnica: model nie „pamięta” Twoich danych. On je wyszukuje w momencie zapytania. Oznacza to, że nowy regulamin lub umowa mogą być dostępne dla systemu po ich ponownym przetworzeniu, synchronizacji i zindeksowaniu – bez ponownego trenowania modelu. Czas aktualizacji zależy od sposobu integracji źródła, harmonogramu synchronizacji i mechanizmu cache.

Jak działa RAG - od pytania do odpowiedzi

Rodzaje źródeł wiedzy: dokumenty, bazy danych, API, systemy ERP

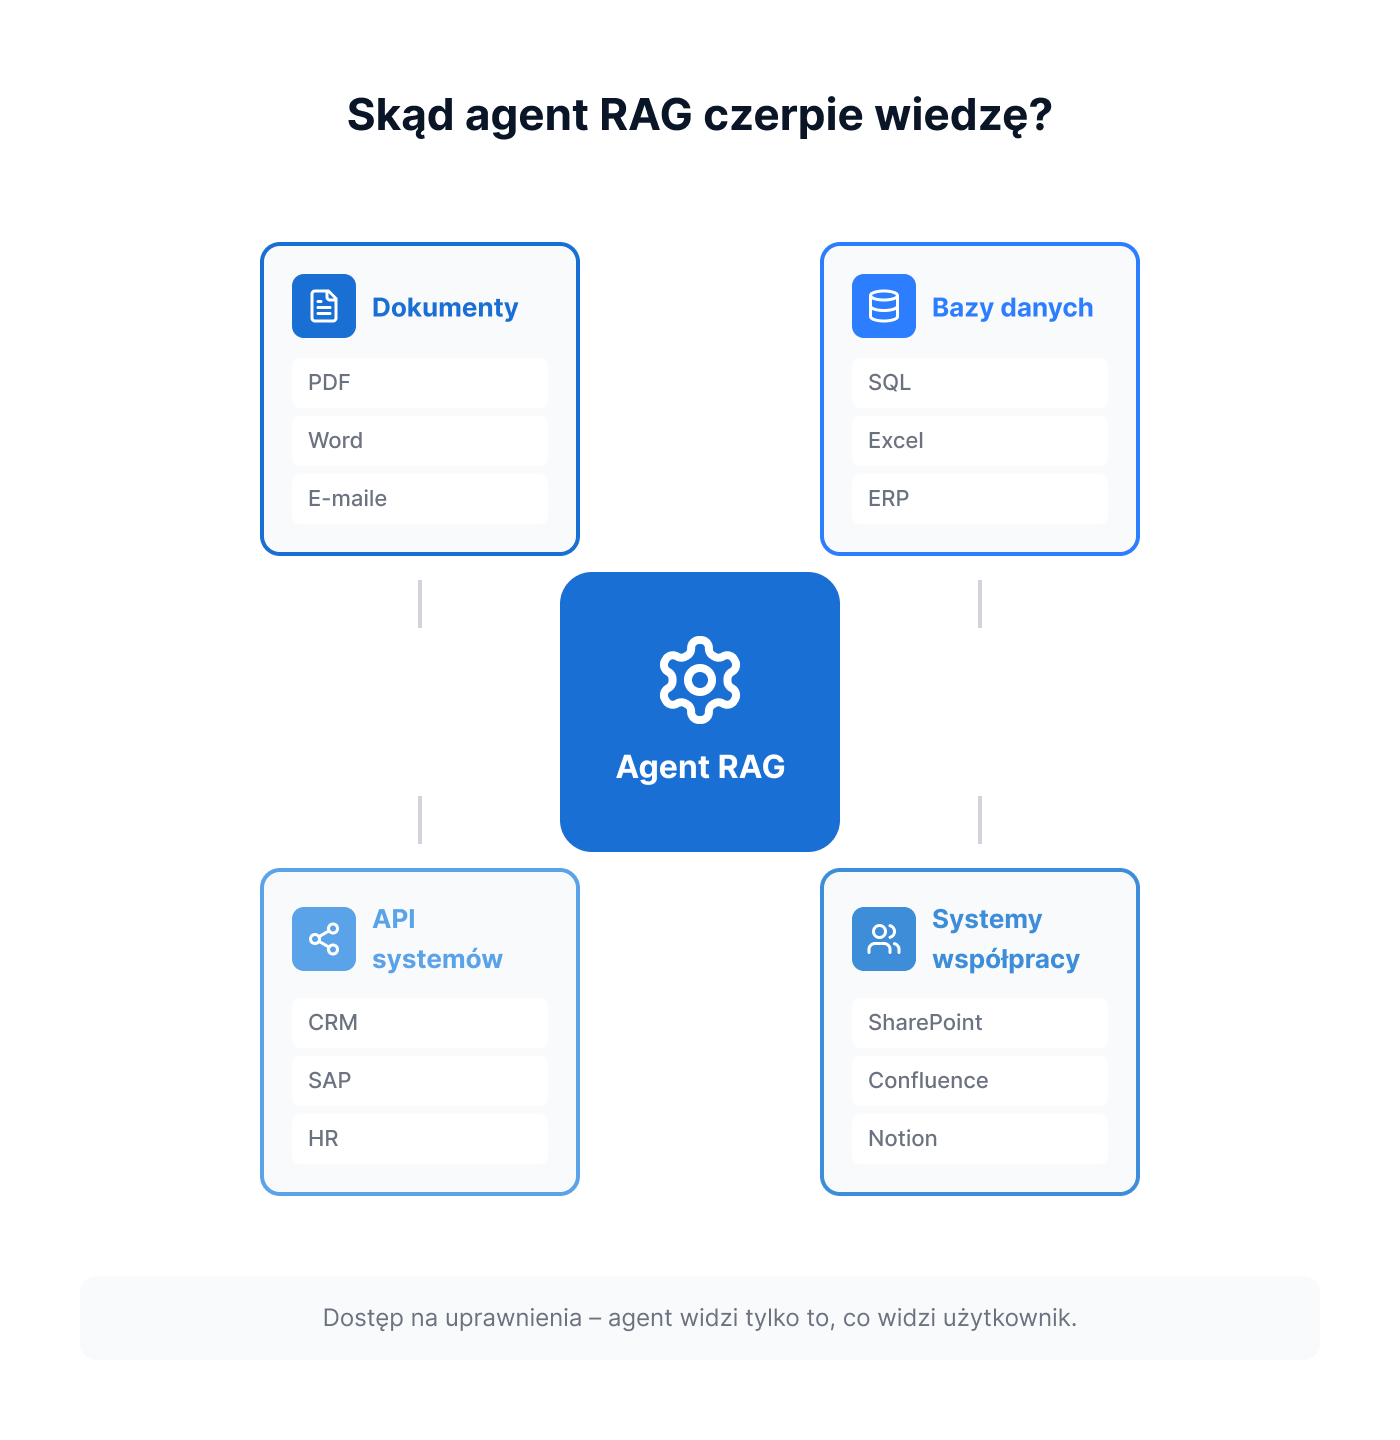
Warstwa RAG najczęściej odpowiada za wyszukiwanie wiedzy w dokumentach i innych zindeksowanych treściach. W szerszej architekturze agenta może być uzupełniona o narzędzia odpytujące bazy danych, API i systemy operacyjne. Mechanizmy te współpracują ze sobą, ale nie są technicznie tym samym:

Dokumenty niestrukturalne
PDF, Word, PowerPoint, e-maile, transkrypcje spotkań. Wymagają preprocessingu – chunking (podział na fragmenty), ekstrakcja tekstu, indeksowanie. Najczęstszy punkt startowy dla wdrożeń enterprise.

Bazy danych strukturalne
Agent może użyć osobnego narzędzia Text-to-SQL, które generuje i wykonuje kontrolowane zapytanie na podstawie pytania w języku naturalnym i zwracać dane liczbowe lub agregowane. Przykład: „Jaki był średni czas realizacji zamówień w Q1?” – agent zapytuje bazę danych sprzedażowej.

API systemów wewnętrznych
CRM (Salesforce, HubSpot), ERP (SAP, Comarch, Microsoft Dynamics), systemy HR, ticketingowe. Agent może odpytywać API w momencie realizacji zapytania, dzięki czemu korzysta ze stanu danych dostępnego w systemie źródłowym. Ich aktualność nadal zależy od jakości danych źródłowych, cache, opóźnień synchronizacji i dostępności integracji.

Systemy współpracy
SharePoint, Confluence, Notion, Google Drive. Dokumentacja projektowa, wiki wewnętrzne, procedury operacyjne. Wymagają odpowiedniego zarządzania uprawnieniami – agent powinien widzieć tylko to, do czego dany użytkownik ma dostęp.

Złota zasada projektowania: zacznij od jednego, dobrze ustrukturyzowanego źródła. Próba podłączenia wszystkich systemów jednocześnie w pierwszym wdrożeniu to jeden z najczęstszych błędów, który prowadzi do niskiej jakości odpowiedzi i trudnej diagnostyki.

Skąd RAG czerpie wiedzę?

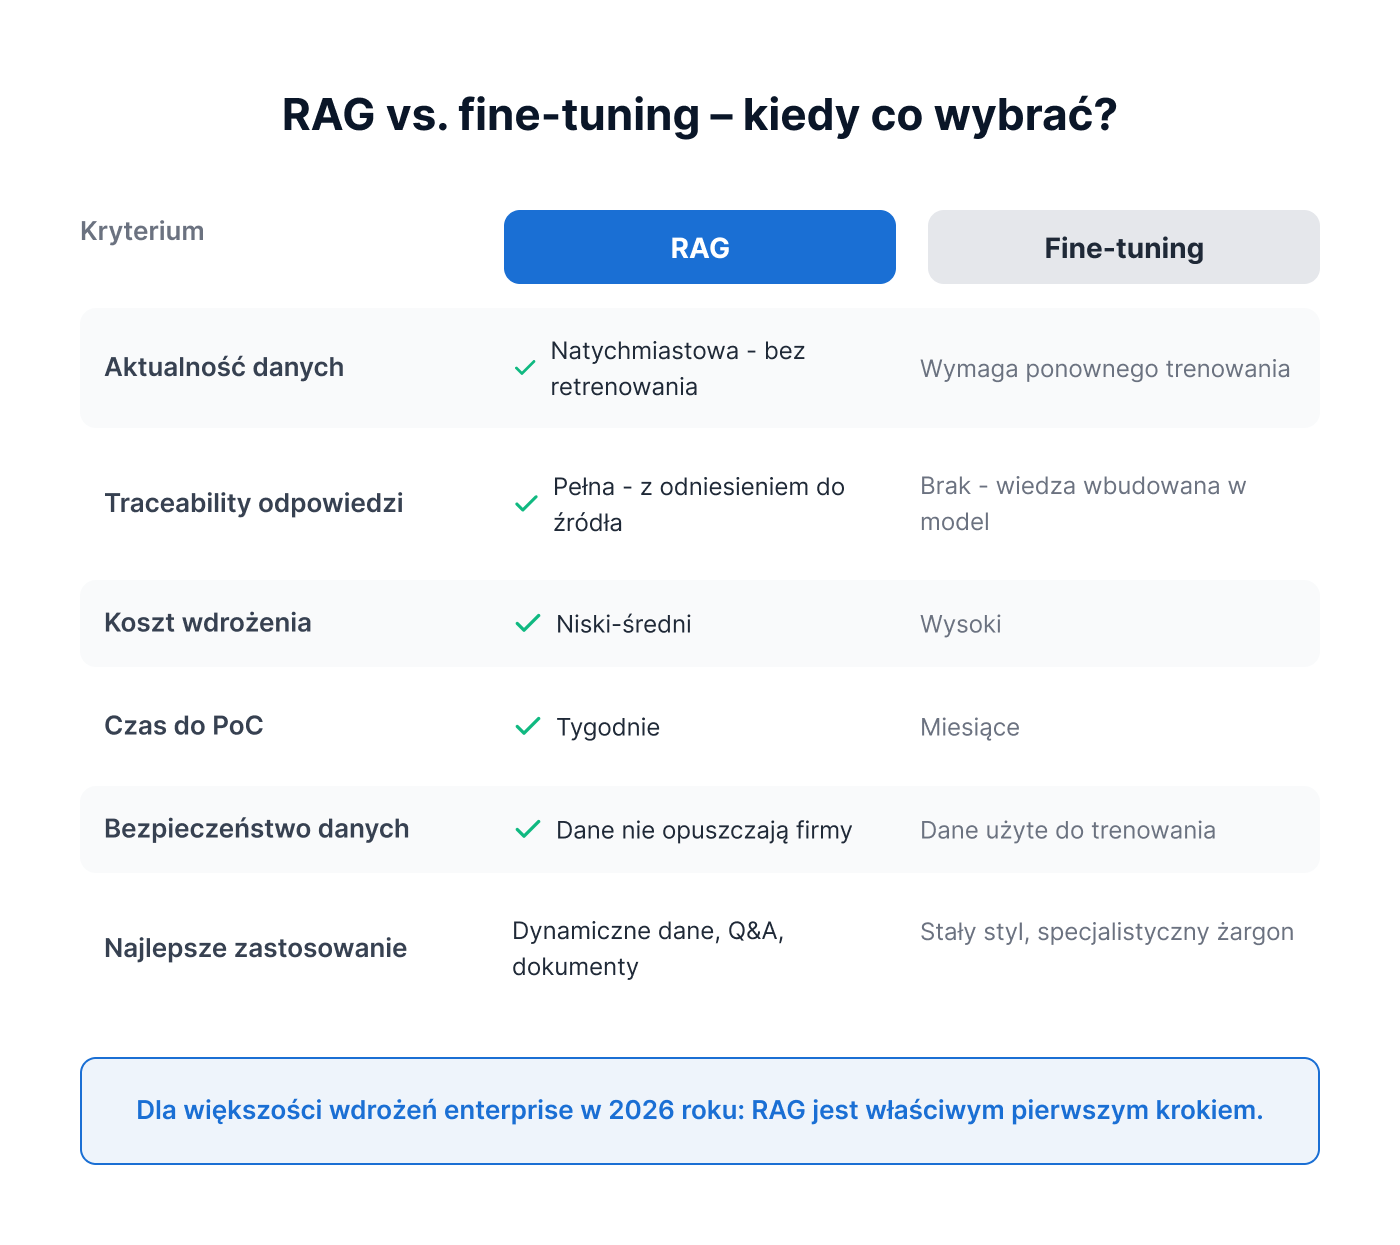
RAG vs. fine-tuning – co wybrać i kiedy

To jedno z najczęściej zadawanych pytań przez CTO przed podjęciem decyzji architektonicznej. Odpowiedź zależy od tego, czego potrzebujesz.

RAG jest właściwym wyborem gdy:

  • Twoje dane zmieniają się regularnie (nowe umowy, aktualizacje procedur, nowe dane z systemów) – RAG nie wymaga ponownego trenowania przy każdej zmianie
  • Potrzebujesz możliwości śledzenia źródeł odpowiedzi – system RAG może zwracać dokumenty i fragmenty wykorzystane podczas generowania, pod warunkiem że mechanizm provenance i cytowania został prawidłowo zaimplementowany i przetestowany
  • Dane są wrażliwe i nie powinny być wykorzystywane do aktualizacji parametrów modelu. Należy jednak pamiętać, że fragmenty pobrane przez RAG mogą być przekazywane do modelu podczas inferencji, dlatego trzeba zweryfikować sposób hostowania, retencję danych, warunki dostawcy i lokalizację przetwarzania.
  • Chcesz szybko wdrożyć i iterować – PoC z RAG można postawić w tygodnie, nie miesiące
  • Zakres pytań jest szeroki i trudny do przewidzenia z góry

Fine-tuning ma sens gdy:

  • Chcesz zmienić styl, ton lub format odpowiedzi modelu (np. zawsze odpowiada jak ekspert prawny)
  • Masz bardzo specyficzne zadanie z dobrze zdefiniowanym zestawem danych treningowych
  • Potrzebujesz poprawić rozumienie specjalistycznego żargonu branżowego przez model
  • Dysponujesz budżetem na trenowanie i infrastrukturą do jego utrzymania

Szczegółowe porównanie obu podejść z perspektywy enterprise, w tym kwestii kosztów, governance i czasu wdrożenia, znajdziesz w enterprise guide Matillion: RAG vs fine-tuning.

W praktyce: RAG + fine-tuning razem
RAG i fine-tuning mogą się uzupełniać: fine-tuning dostosowuje zachowanie modelu do konkretnego zadania, a RAG dostarcza aktualny kontekst z firmowych źródeł. Połączenie obu podejść ma sens wtedy, gdy testy pokażą, że sam RAG nie zapewnia wymaganej jakości.

W przypadku firmowych systemów Q&A, wyszukiwania dokumentów i wiedzy, która regularnie się zmienia, RAG jest często rozsądnym pierwszym krokiem. Potwierdza to analiza Monte Carlo AI: RAG jest generalnie lepszym wyborem dla środowisk enterprise ze względu na bezpieczeństwo, skalowalność i koszt utrzymania. Ostateczny wybór powinien jednak wynikać z testów jakości, wymagań bezpieczeństwa, wolumenu zapytań, kosztów i oczekiwanych czasów odpowiedzi.

RAG vs FineTuning - kiedy co wybrać?

Jak zminimalizować halucynacje agenta AI w środowisku produkcyjnym

RAG może istotnie ograniczyć halucynacje, ale ich nie eliminuje. Błędy mogą wynikać z nieaktualnych dokumentów, nieprawidłowego podziału treści, słabego wyszukiwania, niewłaściwego rankingu wyników albo z tego, że model błędnie zinterpretuje poprawnie pobrany kontekst. Dlatego jakość systemu zależy zarówno od danych, jak i od całego pipeline’u retrievalu i generowania.

Pięć praktyk, które stosujemy przy każdym wdrożeniu produkcyjnym:

1. Zamknięta baza wiedzy, nie otwarty internet
Agent powinien odpowiadać wyłącznie na podstawie zindeksowanych dokumentów firmowych – nie sięgając do internetu. Jeśli odpowiedź nie ma podstawy w bazie, agent powinien powiedzieć „nie znalazłem odpowiedzi w dostępnych dokumentach” – nie wymyślać.

2. Chunking z zachowaniem kontekstu
Podział dokumentów na fragmenty (chunks) to kluczowy krok preprocessing. Zbyt małe fragmenty tracą kontekst. Zbyt duże obniżają precyzję wyszukiwania. Dla dokumentów proceduralnych zakres 300–600 tokenów może być użytecznym punktem startowym, ale nie jest uniwersalnym optimum. Wielkość fragmentów, overlap i sposób podziału powinny być dobrane na podstawie struktury dokumentów oraz testów retrievalu na reprezentatywnym zestawie pytań.

3. Retrieval z re-rankingiem
Pierwsze wyszukiwanie wektorowe zwraca kandydatów. Re-ranker, na przykład cross-encoder, ponownie ocenia trafność kandydatów względem pytania i zmienia ich kolejność. Może ograniczyć udział słabych dopasowań w kontekście, ale nie gwarantuje, że wszystkie nieistotne fragmenty zostaną usunięte.

4. Walidacja odpowiedzi przed zwróceniem
W krytycznych procesach (weryfikacja dokumentów finansowych, odpowiedzi na pytania prawne) odpowiedź agenta powinna przejść przez dodatkowy krok walidacji – czy jest zakorzeniona w cytowanych fragmentach źródłowych, czy nie zawiera informacji spoza kontekstu.

5. Monitoring i feedback loop
System rejestruje niezbędne metadane, wyniki retrievalu, eskalacje oraz oceny użytkowników. Treść zapytań powinna być logowana wyłącznie w zakresie potrzebnym do monitoringu, z uwzględnieniem maskowania danych osobowych, kontroli dostępu i ustalonego okresu retencji. Analiza ocen negatywnych pozwala identyfikować słabe punkty systemu i poprawiać je iteracyjnie.

Przykład architektury: agent RAG dla działu finansowego

Żeby nie mówić abstrakcyjnie – pokażemy to na konkretnym przypadku z naszych wdrożeń.

Jeden z naszych partnerów potrzebował agenta AI, który odpowiada na pytania dotyczące warunków umów z kontrahentami – stawek, terminów płatności, zapisów dotyczących kar umownych. Dotychczas każde takie pytanie wymagało przeszukania archiwum umów lub zapytania do prawnika.

Architektura wdrożenia:

→ Źródła wiedzy: archiwum umów w formacie PDF (kilkaset dokumentów), aktualny cennik usług w formacie Excel, regulamin wewnętrzny działu finansowego.

→ Pipeline: dokumenty są preprocessowane (OCR dla skanów, ekstrakcja tekstu), dzielone na fragmenty z metadanymi (numer umowy, kontrahent, data), indeksowane w bazie wektorowej hostowanej na infrastrukturze EU-only.

→ Zapytanie: użytkownik pyta w naturalnym języku przez interfejs webowy lub integrację z MS Teams. Agent wyszukuje odpowiednie fragmenty, generuje odpowiedź i zwraca ją z odniesieniem do konkretnej umowy i sekcji.

→ Bezpieczeństwo: dostęp zgodny z uprawnieniami użytkownika, minimalizacja i tam, gdzie to możliwe, pseudonimizacja danych przed przekazaniem ich do modelu oraz kontrolowany log audytowy z określonym zakresem i okresem retencji.

Efekt: czas uzyskania odpowiedzi na pytanie o warunki umowy – z kilkudziesięciu minut (szukanie w archiwum lub czekanie na odpowiedź prawnika) do kilkunastu sekund. Każda odpowiedź weryfikowalna – powiązana ze źródłowym dokumentem.

→ Sprawdź, jak ITSharkz projektuje i wdraża agentów AI

Agent RAG dla działu finansowego - schemat wdrożenia

Podsumowanie

RAG nie jest modą. Jest odpowiedzią na fundamentalne ograniczenie standardowych modeli językowych w środowisku enterprise – brak dostępu do aktualnych, firmowych danych.

Trzy rzeczy, które warto zapamiętać:

  • RAG dostarcza modelowi kontekst z firmowych źródeł. Ogranicza to ryzyko odpowiedzi nieopartych na danych, ale nie usuwa go całkowicie – system nadal wymaga testów retrievalu, zgodności odpowiedzi ze źródłami i obsługi sytuacji, w których nie znaleziono wystarczających informacji.
  • RAG nie wymaga wykorzystywania dokumentów do aktualizacji parametrów modelu, ale pobrane fragmenty mogą być przetwarzane przez model podczas inferencji. Bezpieczeństwo zależy więc od architektury, sposobu hostowania, kontroli uprawnień, warunków dostawcy i zasad retencji danych.
  • Jakość RAG zależy od jakości danych. Chaotyczne i nieaktualne dokumenty są jednym z głównych źródeł problemów, ale jakość rozwiązania zależy również od chunkingu, wyszukiwania, rankingu, instrukcji dla modelu, kontroli dostępu i procesu ewaluacji.

Jeśli zastanawiasz się, jak RAG wpisuje się w szerszy plan automatyzacji procesów w Twojej firmie, przeczytaj przewodnik po wdrożeniu automatyzacji AI – w tym jak wybrać właściwy przypadek pilotażowy i jak wygląda timeline od warsztatu do produkcji. A jeśli widzisz zastosowanie RAG konkretnie w obszarze HR i knowledge managementu, sprawdź artykuł o automatyzacji HR z AI.


Omów architekturę swojego agenta AI z zespołem ITSharkz.
→ Umów bezpłatny warsztat

Automatyzacja AI w HR – od onboardingu po analizę kosztów rotacji

Dział HR w firmie 200+ pracowników robi dwie rzeczy jednocześnie: zarządza strategicznym zasobem, jakim są ludzie, i obsługuje niekończącą się kolejkę powtarzalnych zapytań. „Ile mam dni urlopowych?” „Kiedy wypłata?” „Jak złożyć wniosek o L4?”

Te pytania zadawane są dziesiątki razy dziennie. Każde z nich odbiera czas komuś, kto powinien robić coś innego.

Badania Deloitte wskazują, że działy HR spędzają do 57% czasu pracy na zadaniach administracyjnych. Powtarzalnych, opartych na regułach, idealnie nadających się do automatyzacji. A mimo to większość polskich firm zatrzymała się na poziomie „chatbota do FAQ” – skryptu z gotowymi odpowiedziami, który frustruje pracowników bardziej, niż im pomaga.

Agent AI to inna kategoria narzędzi. Ten artykuł pokazuje, gdzie w HR robi realną różnicę – i gdzie granicę wyznacza zdrowy rozsądek.

Jeśli dopiero zaczynasz temat agentów AI w swojej firmie, zacznij od artykułu wprowadzającego o agentach AI. Tu zakładamy, że technologia jest już dla Ciebie jasna i interesuje Cię jej zastosowanie w HR.

Gdzie HR traci czas w 2026 roku

Zanim przejdziemy do rozwiązań, warto nazwać problem precyzyjnie. Nie każde zadanie HR jest powtarzalne. Ale wystarczająco dużo z nich jest, żeby problem miał skalę.

Najczęstsze obszary, w których dział HR firmy 100–500 pracowników traci czas:

  • Onboarding nowych pracowników – przydzielanie dostępów, wysyłanie dokumentów, koordynacja szkoleń, zbieranie podpisów. Przy regularnym zatrudnianiu kilku osób miesięcznie każdy onboarding może oznaczać wiele godzin pracy HR rozłożonej na kilka dni i kilka systemów.
  • Odpowiedzi na powtarzalne pytania pracowników – urlopy, regulaminy, benefity, procedury. Znaczna część zapytań kierowanych do HR dotyczy informacji, które są już zapisane w regulaminach, politykach lub wewnętrznych systemach.
  • Administracja dokumentami – umowy, aneksy, zaświadczenia, wnioski. Koordynacja między pracownikiem, HR, prawnikiem i księgowością przy każdej zmianie.
  • Raportowanie i analityka – zestawienia dla zarządu, dane o absencji, rotacji i kosztach zatrudnienia. W wielu firmach raporty te nadal są przygotowywane ręcznie na podstawie danych z kilku systemów i arkuszy Excel.

Każde z tych zadań ma swoją cenę – bezpośrednią i pośrednią. W każdym z nich można zautomatyzować część pracy, choć dokładny zakres zależy od procesu, jakości danych i wymaganych kontroli.

Gdzie HR traci czas - struktura zadań

Agent AI w onboardingu – co można zautomatyzować bez utraty ludzkiego kontaktu

Onboarding to jeden z procesów, w których automatyzacja ma najszybszy i najbardziej mierzalny zwrot. Firmy stosujące AI w onboardingu raportują redukcję czasu trwania procesu o 53% i oszczędności rzędu 18 000 USD rocznie w przeliczeniu na koszty administracyjne HR i managerów, według danych iTacit.

Co konkretnie może przejąć agent AI:

Przed pierwszym dniem:
Automatyczne wysyłanie dokumentów do podpisania (umowa, RODO, regulamin), zbieranie danych do systemu kadrowego, uruchamianie procesu nadania dostępów na podstawie roli i działu, zgodnie z politykami uprawnień i wymaganymi akceptacjami, harmonogram szkoleń wstępnych, instrukcja pierwszego dnia.

W pierwszym tygodniu:
Automatyczne przypomnienia o szkoleniach obowiązkowych, odpowiedzi na powtarzalne pytania nowego pracownika (gdzie jest kuchnia, jak złożyć wniosek urlopowy, kto jest opiekunem wdrożenia), zbieranie feedbacku po każdym etapie.

W pierwszym miesiącu:
Monitorowanie realizacji szkoleń, automatyczne alerty dla HR i managera przy braku postępów, zebrane dane do oceny skuteczności onboardingu.

Czego agent AI nie zastąpi: pierwszej rozmowy z managerem, lunchu integracyjnego, budowania relacji z zespołem. To nie jest ograniczenie narzędzia – to jego właściwy zakres. Dobra automatyzacja onboardingu uwalnia czas HR na elementy, które wymagają człowieka.

Wewnętrzny asystent HR – odpowiedzi na pytania pracowników bez angażowania działu kadr

To jeden z najczęściej wdrażanych use case’ów i jeden z tych, gdzie ROI widać najszybciej.

Model jest prosty: asystent wiedzy oparty na architekturze RAG ma dostęp do aktualnej dokumentacji HR firmy – regulaminów, polityk, procedur, FAQ, aktualnego układu zbiorowego i informacji o benefitach. Pracownik zadaje pytanie własnymi słowami. System wyszukuje odpowiednie fragmenty dokumentów i generuje odpowiedź z odniesieniem do konkretnego źródła i sekcji. Jeżeli dodatkowo wykonuje działania w systemach HR, może również pełnić funkcję agenta AI.

Różnica względem klasycznego chatbota opartego na regułach jest istotna. Taki chatbot obsługuje wcześniej zdefiniowane pytania i intencje. Asystent RAG może natomiast wyszukiwać informacje w dokumentach i odpowiadać również na pytania, których dokładnego sformułowania nikt wcześniej nie przewidział.

W praktyce oznacza to:

  • „Czy mogę wziąć urlop na żądanie w piątek przed długim weekendem?” – po uwierzytelnieniu pracownika system sprawdza regulamin, datę i dostępne dane urlopowe, a następnie udziela odpowiedzi
  • „Jaka jest procedura zgłoszenia wypadku przy pracy?” – system podaje kroki z aktualnej instrukcji i wskazuje właściwy kontakt, jeżeli sprawa wymaga udziału człowieka
  • „Kiedy mam następną ocenę roczną?” – agent sprawdza cykl ocen w systemie i podaje datę

Każda odpowiedź jest powiązana ze źródłem, co ogranicza ryzyko błędu, ułatwia weryfikację i buduje zaufanie pracowników do systemu.

Wewnętrzny asystent AI - jak działa?

Analiza kosztów rotacji z AI – dane poza standardowym raportowaniem CFO

Rotacja pracowników może być jednym z największych ukrytych kosztów w firmach zatrudniających ponad 100 osób. Szacunki publikowane przez SHRM i Gallup pokazują, że koszt zastąpienia pracownika może wynosić od kilkudziesięciu procent do nawet dwukrotności jego rocznego wynagrodzenia. Rzeczywista wartość zależy od stanowiska, specjalizacji, czasu wakatu i przyjętej metodologii.

Problem polega na tym, że koszty te rzadko są mierzone w jednym, spójnym modelu. CFO zwykle widzi koszt rekrutacji i onboardingu, ale trudniej uchwycić koszt utraconej wiedzy, spadku produktywności w czasie wakatu, dodatkowego obciążenia zespołu i ryzyka kolejnych odejść.

Dobrze zaprojektowany system analityczny zmienia to na dwa sposoby:

Agregacja danych, których nikt nie zestawia razem
System łączy dane z systemu kadrowego, ATS, systemu ocen pracowniczych, narzędzi projektowych i systemów finansowych. Generuje raporty pokazujące, który dział ma najwyższą rotację, kiedy nasilają się odejścia, jaki jest średni koszt zastąpienia pracownika na danym stanowisku oraz w których projektach wakaty korelują z opóźnieniami lub zwiększonym obciążeniem zespołu.

Wczesne sygnały ostrzegawcze
Na podstawie danych historycznych model analityczny może wskazywać zespoły lub grupy stanowisk o podwyższonym ryzyku rotacji. Taki wynik nie jest pewną predykcją ani podstawą do automatycznej decyzji wobec konkretnej osoby – to sygnał do analizy przez HR i managera. Jeżeli system ocenia konkretnych pracowników, wdrożenie wymaga dodatkowej oceny prawnej, kontroli jakości modelu i nadzoru człowieka.

To właśnie kategoria danych, których CFO zwykle nie widzi w standardowym raportowaniu. Może ona istotnie zmienić sposób podejmowania decyzji o inwestycjach w retencję.

Rzeczywisty koszt odejścia jednego pracownika

Bezpieczeństwo danych pracowniczych: hosting w UE, RODO, dostęp na uprawnienia

Dane pracownicze są danymi osobowymi, a część z nich – na przykład dane o zdrowiu lub przynależności związkowej – należy do szczególnych kategorii danych w rozumieniu RODO. Wdrożenie agenta AI w HR bez przemyślanej architektury bezpieczeństwa i zasad przetwarzania danych tworzy poważne ryzyko prawne i reputacyjne.

Kilka zasad, które stosujemy przy każdym wdrożeniu w obszarze HR:

Hosting wyłącznie w UE
Preferujemy hosting i przetwarzanie danych w Europejskim Obszarze Gospodarczym, co upraszcza zarządzanie ryzykiem transferowym. Jeżeli dostawca lub podprocesor przetwarza dane poza EOG, wdrożenie musi obejmować właściwą podstawę transferu i odpowiednie zabezpieczenia. Dostawców infrastruktury dobieramy pod kątem lokalizacji danych, zakresu certyfikacji i warunków korzystania z podprocesorów.

Dostęp na uprawnienia, nie globalny
System uzyskuje dostęp wyłącznie do danych, do których uprawniony jest zalogowany użytkownik. Pytanie o wynagrodzenie innego pracownika nie przyniesie odpowiedzi. Wywołania systemów i narzędzi są rejestrowane zgodnie z przyjętą polityką bezpieczeństwa i retencji danych.

Minimalizacja i pseudonimizacja danych przed LLM
Dane przekazywane do modelu są ograniczane do niezbędnego minimum. Tam, gdzie to możliwe, identyfikatory takie jak imię, nazwisko, PESEL czy numer konta są usuwane, maskowane lub zastępowane tokenami. Jeżeli odpowiedź wymaga danych konkretnego pracownika, system pobiera je przez kontrolowane narzędzie zgodnie z uprawnieniami użytkownika.

Pełna traceability
Rejestrowane są źródło odpowiedzi, użyte narzędzia, wynik i niezbędne metadane. Zakres logowania, dostęp do logów i okres ich przechowywania są ograniczane zgodnie z celem przetwarzania. Pozwala to prowadzić audyt i szybciej reagować na potencjalne incydenty.

Te zasady nie są opcjonalne. Są częścią architektury od pierwszego dnia projektu.
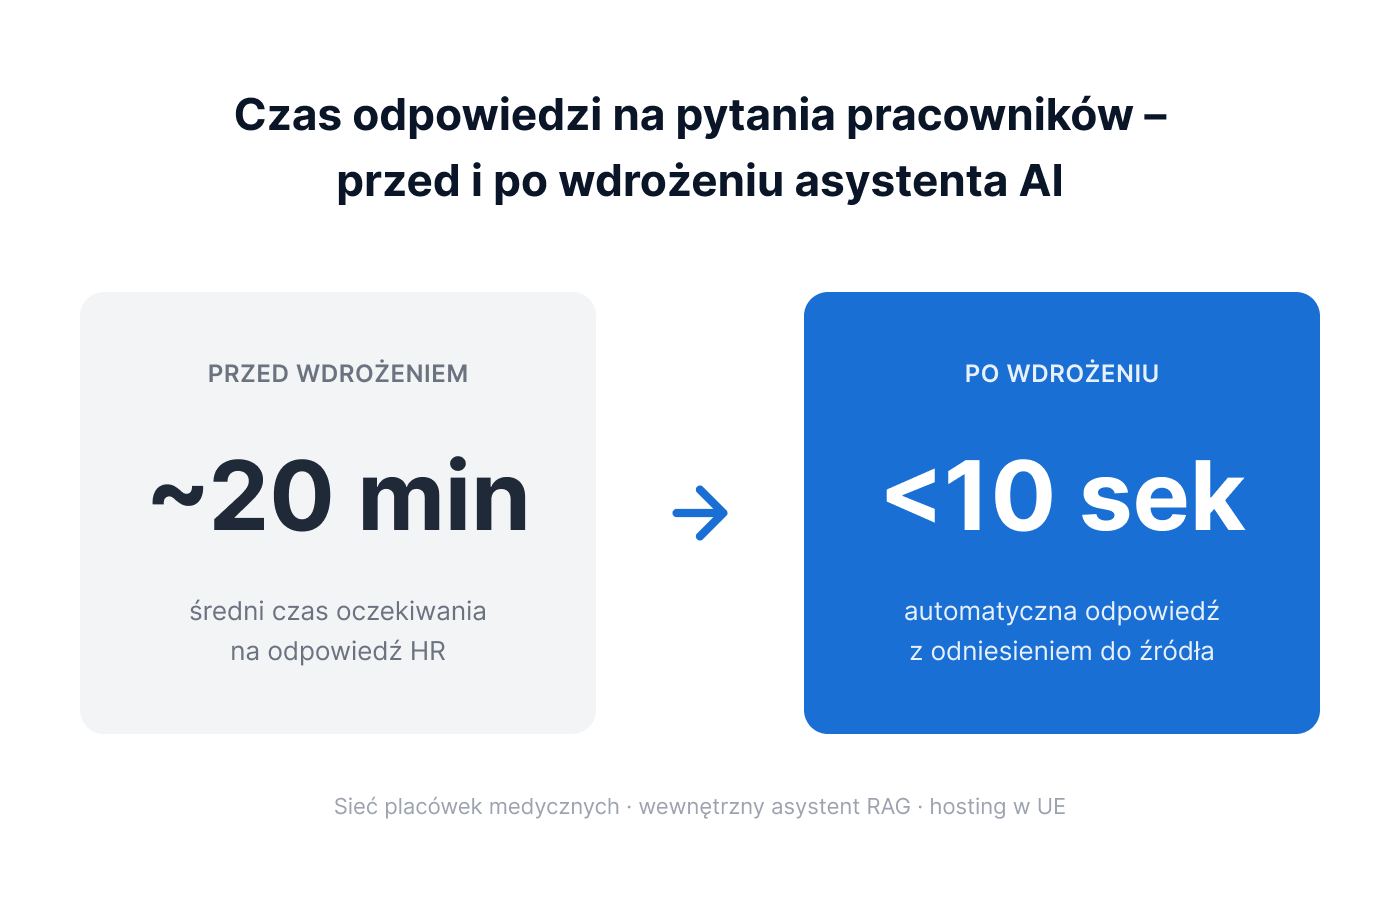
Case study: wewnętrzny asystent AI w organizacji z sektora ochrony zdrowia

W jednym z wdrożeń dla organizacji z sektora ochrony zdrowia dział HR i administracja regularnie otrzymywały powtarzalne pytania o grafiki, regulaminy, polityki urlopowe, szkolenia i procedury zgłaszania incydentów.

Każda odpowiedź wymagała ręcznego sprawdzenia dokumentacji lub kontaktu z właściwą osobą. W rezultacie nawet proste pytania nie zawsze mogły być obsłużone od razu, mimo że odpowiedź znajdowała się już w istniejącej dokumentacji.

Wdrożone rozwiązanie:
Wewnętrzny asystent wiedzy oparty na architekturze RAG, zintegrowany z dokumentacją organizacji. Pracownik zadaje pytanie w naturalnym języku, a system wyszukuje odpowiednie informacje i zwraca odpowiedź z odniesieniem do źródła. Jeżeli pytanie wykracza poza zakres dokumentacji lub wymaga decyzji, sprawa jest kierowana do właściwej osoby razem z kontekstem.

Kluczowe rezultaty:

  • Automatyczna obsługa wielu powtarzalnych pytań informacyjnych
  • Odciążenie działu HR od ręcznego wyszukiwania odpowiedzi
  • Odpowiedzi z odniesieniem do dokumentu źródłowego i możliwością audytu
  • Przetwarzanie danych w wydzielonym środowisku w EOG, zgodnie z ustalonym modelem dostępu i retencji

Wartość tego wdrożenia nie leży tylko w oszczędności czasu. Pracownicy szybciej docierają do aktualnej informacji, a HR angażuje się dopiero wtedy, gdy sprawa wymaga decyzji lub indywidualnej interpretacji.

Czas odpowiedzi na pytania pracowników przed i po wdrożeniu asystenta AI

→ Sprawdź, jak ITSharkz wdraża agentów AI w obszarze HR i operacji

Podsumowanie

Automatyzacja AI w HR to nie zastąpienie ludzi. To uwolnienie ich od zadań, które nie wymagają człowieka – żeby mogli skupić się na tych, które wymagają.

Trzy rzeczy, które warto zapamiętać:

  • Onboarding to jeden z procesów, w których automatyzacja może przynieść szybki i mierzalny zwrot – szczególnie gdy HR ręcznie koordynuje dokumenty, dostępy, szkolenia i przypomnienia.
  • Wewnętrzny asystent wiedzy oparty na RAG ogranicza liczbę powtarzalnych pytań kierowanych do HR i zwraca odpowiedzi z odniesieniem do dokumentu źródłowego.
  • Analiza rotacji z AI łączy dane HR, finansowe i projektowe, dzięki czemu CFO może lepiej oszacować ukryte koszty odejść i ocenić, gdzie inwestycje w retencję mają największe uzasadnienie.

Każde z tych wdrożeń wymaga właściwej architektury bezpieczeństwa i governance danych – kontroli dostępu, minimalizacji danych, zasad logowania i retencji oraz kontroli transferów. Zgodność z RODO zależy również od podstawy prawnej, transparentności wobec pracowników, zarządzania procesorami i oceny skutków dla ochrony danych, jeśli jest wymagana.

Jeśli zastanawiasz się, jak wygląda metodologia wdrożenia od warsztatu do produkcji, przeczytaj przewodnik po wdrożeniu automatyzacji AI w firmie. A jeśli temat dotyczy Cię od strony obsługi klienta lub knowledge managementu – sprawdź artykuł o agentach AI w obsłudze klienta.

Porozmawiaj z zespołem ITSharkz o automatyzacji HR w Twojej firmie.
→ Umów bezpłatną konsultację

Jak wdrożyć automatyzację AI w firmie – przewodnik dla niecierpliwych (z PoC w 4 tygodnie)

Większość firm, które pytają nas o wdrożenie AI, zaczyna rozmowę tak samo: „Chcemy wdrożyć agenta AI w dziale finansowym / do obsługi faktur / w dziale HR / w dziale legalnym. Od czego zacząć?”

To dobre pytanie. Problem pojawia się, gdy zanim ktokolwiek zdąży odpowiedzieć, pada kolejne: „Widzieliśmy demo narzędzia X – może po prostu to wdrożymy?”

I tu zaczyna się najczęstszy błąd w projektach automatyzacji AI.

Narzędzie nie jest punktem startowym. Proces jest. Firmy, które zaczynają od wyboru platformy, a nie od zdefiniowania problemu, kończą z dobrze skonfigurowanym narzędziem robiącym nieodpowiednią rzecz – lub robiącym właściwą rzecz, ale za dużo kosztującym, żeby to miało sens.

Ten artykuł jest przewodnikiem dla decydentów, którzy zdecydowali się na automatyzację AI i chcą zrobić to właściwie. Nie tłumaczymy tu, czym są agenci AI – jeśli potrzebujesz tego kontekstu, zacznij od naszego artykułu wprowadzającego. Tu zakładamy, że jesteś gotowy do działania i interesuje Cię jak, nie co.

Błąd numer jeden: zaczynanie od narzędzia, nie od procesu

Rynek narzędzi AI rośnie szybciej niż zdolność firm do ich oceny. Make, n8n, LangChain, AutoGen, Microsoft Copilot Studio, własne rozwiązania LLM – każde z nich ma swoich zwolenników i każde rozwiązuje inne problemy.

Żadne z nich nie powie Ci, który proces warto zautomatyzować.

Właściwa kolejność to:

  1. Zidentyfikuj proces z najwyższym wolumenem powtarzalnych zadań i mierzalnym kosztem
  2. Oceń, czy dane są dostępne i wystarczająco ustrukturyzowane
  3. Zdefiniuj, jak wygląda sukces i jak go zmierzysz
  4. Dopiero wtedy dobierz narzędzie do problemu – nie odwrotnie

To brzmi oczywiście. W praktyce większość firm pomija kroki 1-3, bo presja czasowa i ciekawość technologii są silniejsze niż dyscyplina procesowa. Partner techniczny, który nie zadaje pytań o kroki 1-3 przed pokazaniem demo – powinien być sygnałem ostrzegawczym.

Jak wybrać właściwy przypadek pilotażowy

PoC (Proof of Concept) nie powinien być ambitnym projektem. Powinien być jak najmniejszy zakres, który pozwoli odpowiedzieć na pytanie: czy automatyzacja AI działa w naszym środowisku i przynosi mierzalną wartość?

Dobry przypadek pilotażowy spełnia cztery kryteria:

Wysoki wolumen, niska złożoność decyzji
Proces, który wykonuje się setki razy miesięcznie, ale każda iteracja przebiega według podobnego schematu. Weryfikacja faktur od stałych dostawców, odpowiedzi na powtarzalne pytania klientów, routing zgłoszeń serwisowych – to dobry materiał na PoC. Skomplikowane negocjacje kontraktowe – nie.

Dostępne i ustrukturyzowane dane
Agent potrzebuje danych do pracy. Jeśli informacje kluczowe dla procesu żyją w mailach jako freetext, w głowach konkretnych pracowników lub w systemach bez API – PoC będzie walczył z infrastrukturą, nie testował automatyzację. To problem do rozwiązania przed, nie w trakcie pilotażu.

Mierzalny efekt
Wybierz proces, w którym potrafisz zmierzyć stan przed i po. Liczba godzin spędzonych tygodniowo, średni czas obsługi zgłoszenia, procent błędów manualnych, koszt zamknięcia miesiąca. Bez bazowej metryki nie masz ROI – masz tylko opinie.

Niskie ryzyko awarii
Jeśli agent popełni błąd w pilotażu – koszt tego błędu jest do naprawienia. Dlatego pierwsze wdrożenia często działają w trybie „suggest only” – agent rekomenduje, człowiek zatwierdza.

Co powinien zawierać PoC – i co NIE jest PoC

To rozróżnienie jest ważne, bo wiele firm myli demonstrację z dowodem koncepcji.

Demo to nie PoC. Demo pokazuje, że narzędzie potrafi coś zrobić w kontrolowanym środowisku, na przykładowych danych. Imponujące, ale bezużyteczne jako podstawa decyzji inwestycyjnej.

PoC to nie MVP. MVP (Minimum Viable Product) to pierwszy produkt gotowy do użycia przez końcowych użytkowników. PoC ma odpowiedzieć na pytanie, czy podejście jest wykonalne i dostarcza założone wyniki.

Dobry PoC zawiera:

  • Realne dane Twojej firmy (nawet zanonimizowane) – nie przykładowe zestawy danych dostarczane przez dostawcę
  • Jeden konkretny podproces – nie „automatyzację obsługi klienta” jako całości, ale np. „automatyczną weryfikację faktur od 10 stałych dostawców”
  • Mierzalne KPI zdefiniowane przed startem – procent przypadków obsłużonych poprawnie, czas przetwarzania, liczba eskalacji
  • Zdefiniowaną definicję sukcesu – przy jakim poziomie skuteczności rekomendujecie przejście do pełnego wdrożenia?

Czego PoC nie musi zawierać: pełnego UI, dokumentacji produkcyjnej, integracji ze wszystkimi systemami, obsługi 100% przypadków brzegowych.

Timeline: od warsztatu do wdrożenia produkcyjnego

Poniżej realistyczny harmonogram dla typowego projektu automatyzacji AI w firmie 50-400 pracowników. Zakłada jeden konkretny proces, jeden system do integracji i zespół po stronie firmy gotowy do współpracy.

Tydzień 1-2: Warsztat discovery
Mapowanie aktualnego procesu, identyfikacja wolumenu i wąskich gardeł, ocena jakości i dostępności danych, ustalenie reguł biznesowych, zdefiniowanie KPI i definicji sukcesu. To najważniejszy etap – decyduje o tym, czy projekt trafi w cel.

Tydzień 3-4: Konfiguracja agenta
Setup środowiska, praca z danymi produkcyjnymi, konfiguracja modelu i reguł, testy na danych historycznych.

Tydzień 5-6: PoC i kalibracja
Uruchomienie agenta na realnych danych w trybie „suggest only”, pomiar skuteczności względem zdefiniowanych KPI, iteracyjna kalibracja reguł i modelu.

Tydzień 7: Decyzja i zakres
Raport PoC z konkretnymi wynikami, rekomendacja go/no-go, ustalenie zakresu pełnego wdrożenia i modelu cenowego. Ta decyzja jest tu kluczowa – większość projektów agentów AI utyka właśnie w tym miejscu, bo nikt jej formalnie nie podejmuje.

Tydzień 8-14: Wdrożenie produkcyjne
Pełna integracja, obsługa przypadków brzegowych, onboarding zespołu, uruchomienie monitoringu i dashboardu KPI, follow-up 30/60/90 dni.

Łącznie: 8-14 tygodni od pierwszego warsztatu do systemu działającego na produkcji. Dla prostszych procesów (jeden system, ustrukturyzowane dane) bywa krócej. Dla procesów wymagających wielu integracji lub pracy z chaotycznymi danymi – dłużej.

Czego wymagać od partnera technicznego

To pytanie, które decydenci rzadko zadają wprost przed podpisaniem umowy. Efektem jest rozczarowanie po trzech miesiącach, gdy okazuje się, że „wdrożenie AI” oznaczało konfigurację gotowego narzędzia SaaS z minimalną customizacją.

Checklist, który warto mieć przy ocenie ofert:

Proces i discovery

Czy partner zaczyna od warsztatu discovery, czy od dema narzędzia?
Czy zadaje pytania o dane, integracje i definicję sukcesu zanim przedstawi wycenę?
Czy potrafi powiedzieć „ten proces nie nadaje się do automatyzacji AI – oto dlaczego”?

Technikalia

Czy agent jest budowany pod Twoje dane i procesy, czy jest to gotowy produkt z konfiguracją?
Jak wygląda integracja z Twoimi systemami (ERP, CRM, baza wiedzy)?

Bezpieczeństwo i compliance

Gdzie są hostowane dane – czy w UE?
Czy wdrożenie jest zgodne z RODO i – jeśli dotyczy – z AI Act?

Długoterminowe wsparcie

Czy partner oferuje monitoring i utrzymanie po wdrożeniu?
Jak wygląda model follow-up (30/60/90 dni)?
Czy masz dostęp do dashboardu KPI i raportów skuteczności?

Model cenowy: setup fee + subskrypcja vs. projekt na godziny

Zanim podpiszesz umowę, upewnij się, że rozumiesz, co kupujesz.

Na rynku funkcjonują trzy główne modele:

Projekt na godziny (T&M)
Płacisz za czas pracy zespołu. Elastyczny, ale trudny do budżetowania. Ryzyko przekroczenia zakresu jest po Twojej stronie, jeśli wymagania nie są dobrze zdefiniowane na starcie.

Fixed price
Stała cena za z góry określony zakres. Dobre zabezpieczenie budżetowe, ale wymaga bardzo precyzyjnej specyfikacji przed startem – każda zmiana zakresu generuje aneks. Rzadko spotykany przy projektach AI, gdzie zakres ewoluuje w trakcie PoC.

Setup fee + subskrypcja miesięczna
Jednorazowy koszt wdrożenia i konfiguracji, następnie miesięczna opłata za hosting, utrzymanie, aktualizacje, monitoring, rozwój i wsparcie. Model, który stosujemy w ITSharkz. Jeśli zastanawiasz się, czy jednorazowe wdrożenie nie wyjdzie taniej, sprawdź rachunek na 3 lata dla czterech modeli rozliczeń agenta AI. Zalety: przewidywalny koszt operacyjny, partner ma interes w tym, żeby system działał dobrze długoterminowo (nie tylko przy odbiorze), łatwiej planować TCO na 24 miesiące. W dodatku jest to niska bariera wejścia.

TCO na 24 miesiące – co warto policzyć:

Przy porównaniu ofert uwzględnij nie tylko koszt wdrożenia, ale też:

  • Miesięczny koszt modeli LLM (rośnie z wolumenem)
  • Koszt hostingu i infrastruktury
  • Koszt utrzymania i aktualizacji reguł biznesowych
  • Koszt integracji z nowymi systemami w przyszłości
  • Koszt własnego czasu i zaangażowania zespołu

Tańsze wdrożenie na starcie często oznacza droższe utrzymanie – albo brak utrzymania i degradację systemu w czasie.

Podsumowanie

Wdrożenie automatyzacji AI nie jest projektem IT. Jest projektem biznesowym, który wymaga zaangażowania zarządu, jasno zdefiniowanego problemu i partnera, który rozumie Twoje procesy – nie tylko swoje narzędzia.

Trzy rzeczy, które warto zapamiętać:

  • Zacznij od procesu, nie od narzędzia. Wybierz jeden, konkretny podproces z wysokim wolumenem, mierzalnym kosztem i dostępnymi danymi. PoC w 4-6 tygodniach pozwoli ocenić realny potencjał.
  • PoC to nie demo. Wymaga realnych danych, integracji z systemem produkcyjnym i KPI zdefiniowanych przed startem. Bez tego nie masz podstawy do decyzji.
  • Pytaj o TCO, nie tylko o cenę wdrożenia. Koszt utrzymania, monitoring, aktualizacje reguł i koszt modeli LLM w czasie są częścią rachunku – i decydują o tym, czy projekt naprawdę się opłaca.

Jeśli chcesz zobaczyć, jak ta metodologia działa w konkretnym sektorze, przeczytaj artykuł o automatyzacji procesów finansowych – ten sam model PoC, konkretna kalkulacja ROI dla działu finansowego.

A jeśli zastanawiasz się, czym w ogóle różni się agent AI od chatbota, który wdrożyłeś kilka lat temu – odpowiedź znajdziesz w artykule o agentach AI w obsłudze klienta. Szukasz wzoru na liczenie ROI, zanim wybierzesz proces do automatyzacji? Koniecznie zobacz ten przewodnik.


Zarezerwuj warsztat z zespołem ITSharkz i zacznij od właściwego kroku.
→ Umów bezpłatny warsztat